 Mores
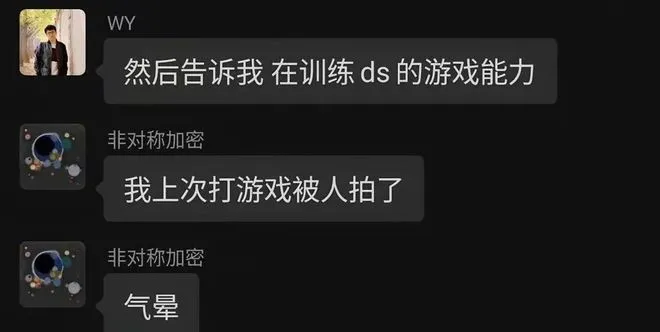
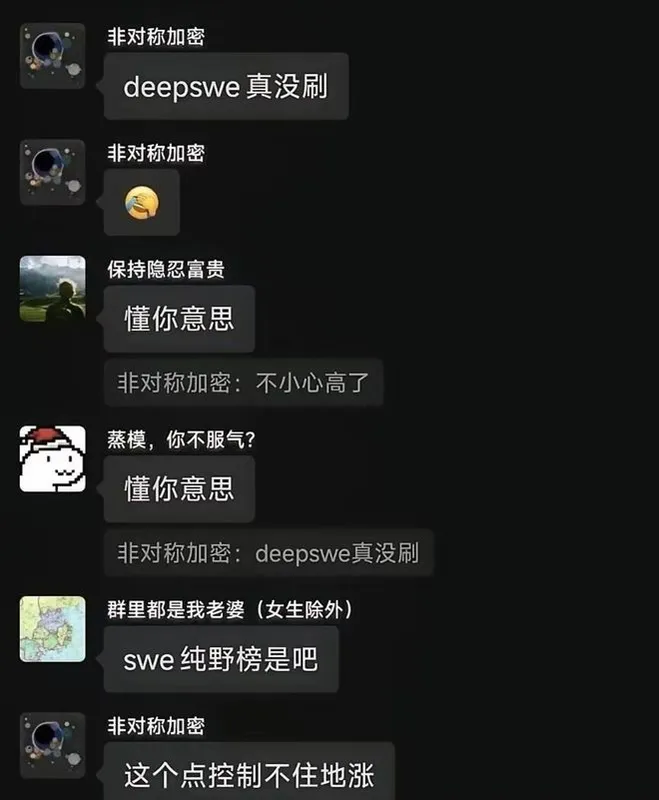
近日,几张疑似 DeepSeek(深度求索)内部员工的群聊截图在网上流传。截图中,一名员工称 DeepSWE 基准“真没刷,不小心高了,这个点控制不住地涨”,另一名疑似后训练团队负责人则调侃“最近在工位玩游戏的太多了”。
相关对话在 AI 圈引发讨论。有网友将其与 DeepSeek 偏爱奥赛金牌得主的用人风格联系起来,也有人借此对比智谱、月之暗面等国内大模型团队当前的竞争处境。
截图里说了什么
流传的截图中,一位ID为“非对称加密”的员工称“deepswe真没刷,不小心高了,这个点控制不住地涨”,随后另一位员工调侃“swe纯野榜是吧”。疑似DeepSeek后训练团队负责人吴俣(ID为WY)接过话头,调侃“然后告诉我,在训练ds的游戏能力”,并感叹“最近在工位玩游戏的太多了”。“非对称加密”则自嘲“我上次打游戏被人拍了,气晕”。
网友@Leo打趣称,没做任何特殊优化,基准分自己涨了,每天都在打游戏,模型能力却越来越强,并提到GLM(智谱)和Kimi(月之暗面)的员工看了会作何感想。另一位网友则称,难怪DeepSeek喜欢招奥赛金牌得主,他们就是那种整天打游戏、最后考试依然满分的人。
需要说明的是,这些截图均为网上流传的疑似内部群聊内容,来源为推特流传的图片,DeepSeek官方并未就此作出公开回应,对话的真实性也未获证实。
DeepSWE 是什么
对话中提到的“deepswe”指向DeepSWE,这是一个衡量AI编程智能体(Agent)解决真实代码库问题能力的基准测试。与普通的代码补全不同,它要求模型能够独立定位Bug、理解复杂的业务上下文,并写出能跑通的补丁。
按流传说法,DeepSeek的最新模型曾在该榜单上拿下超过74%的高分,处于全球第一梯队。员工“真没刷,不小心高了”的说法,被解读为模型进化不再依赖大量低效的人工数据标注和机械微调,而更多依靠底层算法架构创新与强化学习的自发涌现。
这一解读与DeepSeek公开的技术路线相呼应:其引以为傲的MoE(混合专家模型)架构和MLA(多头潜在注意力)技术,被视为模型能力提升的底座。不过,这些关联分析来自自媒体文章,并非公司官方表述。
用人风格与团队文化
网友关于奥赛金牌得主的调侃,点出了DeepSeek用人风格中常被讨论的一面。创始人梁文锋有浓厚的量化背景,其创办的幻方量化曾在A股市场以算力强悍著称。组建DeepSeek团队时,他定下一条反常规的标准:不看大厂履历,偏爱应届生,尤其偏爱顶级数理竞赛的奥赛金牌得主。
文章将这群人的特点概括为极其聪明、纯粹、对技术有狂热信仰。在管理上,DeepSeek被描述为极其扁平,员工不需要靠“996”向老板证明勤奋,也不必把大量时间花在写周报、做PPT汇报和跨部门对齐上。
至于“在工位玩游戏”,文章认为这更像是高强度脑力消耗后的调剂,而非不务正业。这种看似松散、实则专注的氛围,被视作其能做出反直觉突破的土壤。这些描述均出自自媒体观察,未获公司方面确认。
友商的处境
把视角转向友商,这段截图带来的感受被形容为“窒息感”。月之暗面(Kimi)和智谱(GLM)同样是国内顶尖的大模型团队,同样汇聚了名校背景的研发人员,同样在拼命迭代模型,但两家公司的处境和战略重心不同。
智谱脱胎于清华实验室,带有浓厚的学院派色彩。文章称其过去重心在于政企客户的本地化部署,如今已全面向云端API服务(MaaS)转型,API收入占比近期已飙升至八成以上,因此必须维系庞大的企业客户网络,每个版本迭代都要经受商业级应用的考验。
Kimi在长文本领域打响知名度后,曾经历疯狂砸钱投放广告的阶段,但近期已大幅削减营销费用,将资源收回至底层模型研发(如K2系列),试图用技术上限打破僵局。
文章还提到,近一年国内大模型圈陷入“卷榜”模式,为在跑分上压过竞品,工程师通宵达旦,甚至不惜在测试集上做定向优化,因为榜单排名直接挂钩下一轮融资估值和下一季度营销预算。在此背景下,DeepSeek模型开源、API价格压低、跑分进入第一梯队,员工又说“没特意刷”,被指动摇了靠资本堆砌、靠营销驱动的发展叙事。
这种模式的隐忧
文章也指出,极度依赖天才直觉和自由探索的“极客乌托邦”模式并非没有隐忧。首先是商业化挑战:顶尖科学家擅长攻克技术壁垒,但大模型最终要走向市场,如何在保持技术领先的同时构建繁荣的开发者生态,或找到高利润的To B、To C应用场景,DeepSeek显得克制甚至有些佛系,这可能限制其商业价值的最大化。
其次是组织规模的极限。团队只有几十、上百人时,扁平化管理和纯粹的技术驱动能爆发出惊人战斗力;但当公司规模随业务扩张而膨胀,若没有严谨的现代企业管理制度,极客文化容易演变成各自为战的混乱,缺乏外部压力的“自由”也可能滑向效率的深渊。
文章最后称,大模型下半场的竞争焦点正从“谁烧的钱多、谁的显卡多”,回归到“谁的算法更优雅、谁的人才更顶尖”。这些判断属于作者观点,截图本身所反映的团队状态仍有待更多信息印证。
要点
- 截图称 DeepSWE 基准“真没刷,不小心高了”
- DeepSeek 模型曾在 DeepSWE 拿下超过74%的分数
- 后训练团队负责人调侃工位玩游戏的太多
- DeepSeek 招聘偏爱应届生与奥赛金牌得主
- 智谱 API 收入占比近期已飙升至八成以上
正在读取登录状态…
暂无讨论,说说你的看法吧