 Mores
10月23日,月之暗面正式发布新一代旗舰模型 Kimi K3.1 Pro,重新加入全球大模型的密集更新周期。新模型拥有2.8万亿总参数,每次推理激活1040亿参数,支持100万 token 上下文窗口,官方宣布完整模型权重将在11月4日前开放。
据月之暗面公布的测试结果,K3.1 Pro 在编程、智能体、3D 创作和金融研究等方向均有升级,多项成绩超过 OpenAI 的 GPT-6 Astra,在部分项目上逼近或超过 Claude Opus 5.5。独立评测机构 Artificial Analysis 给出的智能指数为55分,排名全球第四。
发布与规格
此次发布距上一代 Kimi K3 推出已有三个多月。过去两个月,全球大模型市场经历了一轮密集更新:9 月 OpenAI 接连推出 GPT-6 Astra、GPT-6 Sol 等模型,Anthropic 也发布了 Claude Opus 5.5 和 Claude Sonnet 5.5,而中国头部厂商的新一代旗舰发布节奏相对平静。K3.1 Pro 的推出使月之暗面重新回到这一竞争序列中。
规格方面,K3.1 Pro 总参数为 2.8 万亿,每次推理激活 1040 亿参数,上下文窗口为 100 万 token。官方表示,完整模型权重将在 11 月 4 日前开放,延续了 K3 以来大规模开放权重的路线。
关键测试成绩
月之暗面公布的编程测试中,K3.1 Pro 在 Terminal-Bench 4.0 上取得 65.7%,高于 GPT-6 Astra 的 58.2%,与 Claude Opus 5.5 的 66.4% 相差 0.7 个百分点。在考察长周期软件工程任务的 SWE-Marathon v1.1 中,它以 51.7% 超过 Claude Opus 5.5 的 46.3% 和 GPT-6 Astra 的 42.5%。
智能体方向上,K3.1 Pro 在 Agents' Last Exam 中获得 43.2 分,高于 Claude Opus 5.5 的 42.6 分和 GPT-6 Astra 的 32.8 分;在允许调用工具的完整版 Humanity's Last Exam 中,以 70.0% 位列官方对比模型首位。官方同时说明,在科学计算终端任务、部分知识推理和 3D 重建测试中,GPT-6 Astra 与 Claude Opus 5.5 仍保持优势。
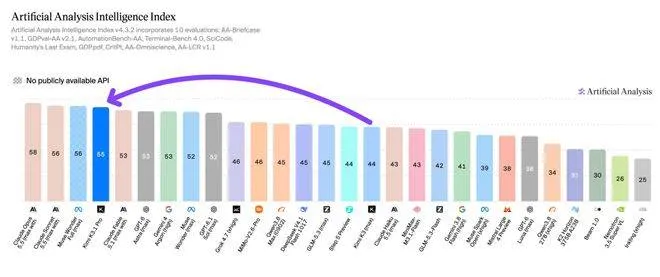
独立评测机构 Artificial Analysis 给出的智能指数为 55 分,全球排名第四,仅次于 Claude Opus 5.5、Claude Sonnet 5.5 和 Muse Wonder Full,较上一代 K3 的 44 分提高 11 分。该机构指出,一旦权重按计划公开,K3.1 Pro 将成为该指数中得分最高的开放权重模型,领先开放权重模型与顶级闭源模型的分差也将从此前的 12 分缩小至 3 分。
3D 与前端演示
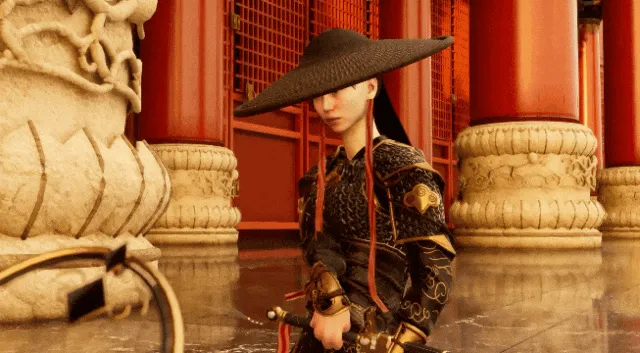
官方公布的作品显示,K3.1 Pro 在视觉与交互内容上的能力有所扩展,可同时处理代码逻辑、页面构图、材质、光照和动画设计。演示包括一款使用虚幻引擎 5.8 开发的天宫对战游戏,模型通过编写代码和调用工具构建大型建筑场景,并结合程序化建模、实时光照及外部素材形成可运行的游戏环境。
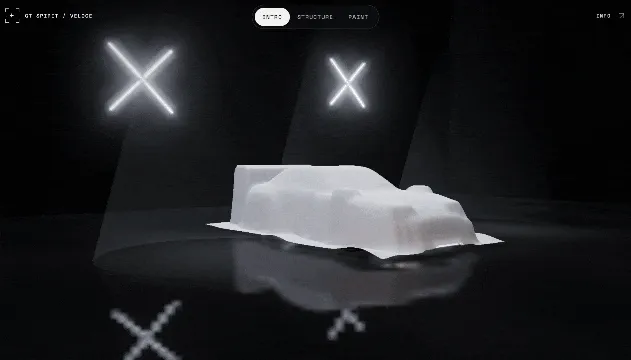
另一项演示是使用 Godot 引擎开发的东方仙侠风格 3D 角色扮演游戏,包含五个可探索区域、两阶段 Boss 战、昼夜循环和篝火传送等机制。此外还有一款 3D 汽车登录页面,将三维车模与网页交互结合,体现模型在前端开发中兼顾功能、视觉与交互的完成度。
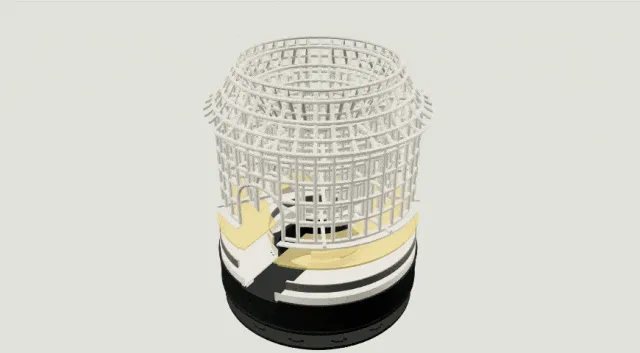
3D 建模方面,模型可根据文字描述、草图或参考图片理解物体结构、比例和空间关系并生成三维模型,也能自行编写和运行 Blender、CAD 等软件脚本,修改几何结构、材质与场景布局。演示包括以福建土楼为灵感、由五个可分别打印部件组成的 3D 打印台灯,以及用 Blender 构建的机场室内雨林场景,后者输出为 19.5 秒、1920×1080 分辨率、每秒 60 帧的视频。月之暗面同步推出 3D Make 功能,用户可在 Kimi 网页和 App 中创建、预览、编辑 3D 模型,下载 3D 打印文件或导出为视频和实况照片。
后训练与强化学习
据月之暗面介绍,K3.1 Pro 是在 K3 基础上进行更大规模后训练得到的,并未从头训练新模型。团队重点扩大了强化学习的计算投入,同时调整强化学习框架、长上下文推理、训练效率、沙盒环境和任务调度系统,使模型能在数百个不同领域的任务中持续学习,并根据执行结果调整策略。这也解释了其进步为何集中在编程、智能体和长周期任务,而非所有知识与推理测试同步大幅领先。
长时间任务能力方面,官方给出一个人体行走模拟实验:模型基于包含 296 个骨骼组件、402 个肌肉组件的开源人体模型编写模拟器并训练虚拟人行走,过程中经历 167 项任务和 420 次独立评审。当手臂运动始终无法改善时,模型回头检查模拟器计算方法,发现并修复 36 处肩部肌肉力臂计算错误,随后重新训练控制器。
金融研究是另一提升明显的领域。在 OfficeQA Pro v2 中,模型需处理真实金融文件,完成信息检索、跨文档核对及多步骤计算,K3.1 Pro 获得 64.4 分,高于 Claude Opus 5.5 的 62.2 分和 GPT-6 Astra 的 54.4 分。内部测试显示,相比 K3,其金融建模成绩提高 7.2 分,金融研究提高 11.6 分,模拟商业运营成绩提升至原来的约 4.2 倍;演示任务包括英伟达财务预测与估值模型、宁德时代投委会报告和量子计算行业研究报告。事实准确性方面,内部 Kimi Hallu Bench Hard 压力测试中,单条事实错误率从 K3 的 23.4% 降至 8.3%,该测试专门挑选易产生事实错误的复杂任务,官方未将其等同于日常使用的总体幻觉率。
定价与可用性
K3.1 Pro 的 API 价格为每百万输入 token 2 美元、每百万输出 token 10 美元,较上一代 K3 对应价格下降约三分之一。官方另推出 Highspeed 版本,称在维持相同模型能力的情况下输出速度提升约 2 至 3 倍,价格相应翻倍。
Artificial Analysis 测得标准版输出速度约为每秒 73.5 个 token,低于同类模型平均水平,完成测试任务时的输出篇幅也偏长,因此实际使用成本和任务耗时仍需结合具体场景判断。目前 K3.1 Pro 已上线 Kimi 网页端、移动端、Kimi Work、Kimi Code 和 API 平台。官方承认,在部分科学推理、工程任务和运行效率上,领先的闭源模型仍保持优势。
要点
- K3.1 Pro 总参数2.8万亿,推理激活1040亿参数
- 支持100万 token 上下文窗口
- Terminal-Bench 4.0 得分65.7%,高于 GPT-6 Astra 的58.2%
- Artificial Analysis 智能指数55分,较 K3 提高11分
- API 价格每百万输入 token 2美元、输出10美元
正在读取登录状态…
暂无讨论,说说你的看法吧