 Mores
10 月 24 日,月之暗面发布 Kimi K3.1 Pro。官方称这是目前最强的 3T 级开放权重模型,单个 token 激活约 1040 亿参数,上下文窗口为 100 万 token,权重最晚 11 月 4 日放出。
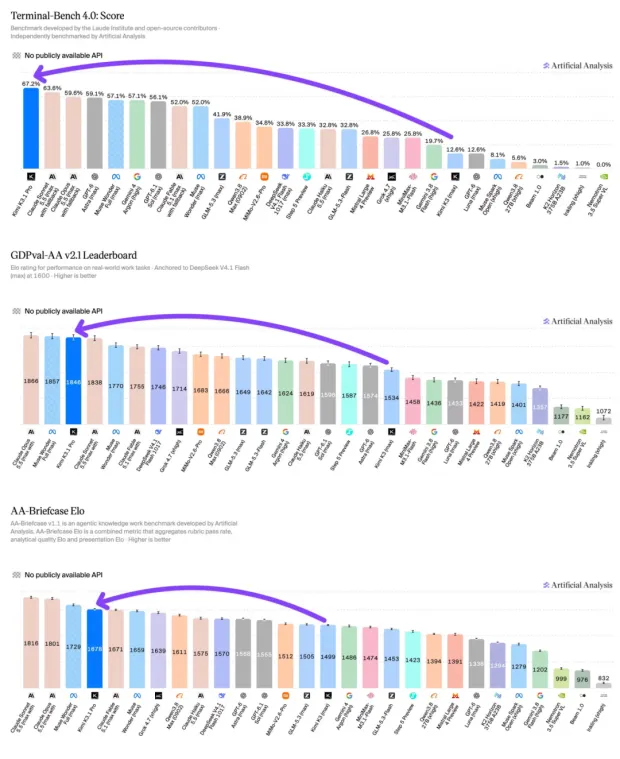
官方公布的编程评测中,K3.1 Pro 在 Terminal-Bench 4.0 上得分 65.7%,高于 GPT-6 Astra 的 58.2%,仅次于 Opus 5.5 的 66.4%。第三方机构 Artificial Analysis 的同一评测中,K3.1 Pro 得分为 67%。
编程与 3D 评测成绩
10 月 24 日恰逢程序员节日,月之暗面选择在这一天推出 Kimi K3.1 Pro。权重最晚 11 月 4 日放出,届时开发者可以自行部署。
从版本关系看,K3.1 Pro 本质上是 K3 的后训练版本。但从产品时间线看,它的上一代产品是 9 月上线的 K2.8。K2.8 发布时官方没有做过多介绍,甚至没有公布跑分榜,评测机构 Goldie 认为它本质上是一个带真实用户流量运行的 A/B 试验场。
K2.8 是月之暗面第一个让全部会员档位体验 100 万 token 上下文窗口的模型,由于结果令人满意,K3.1 Pro 保留了这一窗口。此前 K3 发布时因性能直追 GPT 5.6 Sol 而爆火,大量新用户涌入导致算力紧缺,月之暗面被迫暂停新用户订阅,把有限算力优先留给现有付费用户;到 K3.1 Pro 发布时,尚未出现类似情况。
金融与幻觉率表现
第三方机构 Artificial Analysis 自行运行的同一评测中,K3.1 Pro 得分为 67%,不仅高于月之暗面自己的成绩,也是该机构目前记录到的最高评分。
3D 建模方面,在带工具的 BenchCAD 测试中,K3.1 Pro 为 92.7%,Opus 5.5 为 96.2%,GPT-6 Astra 为 95.9%;不带工具时 K3.1 Pro 为 72.8%,与 Opus 5.5 的 73.0% 几乎持平。在测真实工作任务的 Elo 榜 GDPval-AA 上,K3.1 Pro 得 1846 分,比 K3 提升 312 分,排名第三,落后于 Opus 5.5 的 1866 分和 Muse Wonder Full 的 1857 分。
官方博客把更新归纳为编码、3D 建模和金融三个方向。编码方面,K3.1 Pro 可在 Unity、Unreal Engine 和 Godot 等游戏引擎中工作,并能结合联网搜索与 3D 生成做出完整的游戏和网页体验。3D 建模方面,它擅长参数化建模,无需 MCP 连接器即可自行编写脚本驱动 Blender 和 CAD 软件;配套产品 3D Make 同步上线,支持在线预览、编辑,下载后可直接 3D 打印,也可导出为视频或 Live Photo。
训练方法的变化
金融方向上,K3.1 Pro 在 OfficeQA Pro v2 上得分 64.4,超过 Opus 5.5 的 62.2。这套题使用真实财务文件,考查模型先找到资料、再核对多份文件中的数字是否矛盾、最后逐步算出答案的能力。另一项 Frontier Finance 评测中,K3.1 Pro 得分为 58.6。
事实准确性方面,官方称针对幻觉做了专门优化。测试方法是拿一批专门设计来诱导 AI 犯错的难题,把回答拆成一条条具体说法,再统计其中错误的比例。结果显示,模型的幻觉率从 K3 的 23.4% 降至 K3.1 Pro 的 8.3%。
这一改进与 K3 发布后的反馈有关。当时 Artificial Analysis 的 AA-Omniscience 基准显示,K3 的幻觉率为 51%,高于 K2.6 的 39%。此外 K3 还被认为价格偏高,而 K3.1 Pro 的定价较 K3 下调了 35%。
定价与版本差异
为在数百个下游领域做联合强化学习,月之暗面重做了 RL 框架、长上下文推理、沙箱和 rollout 调度整条链路。除此之外,官方还搭建了一个环境质量检查共享平台,目的是让每多投入一份 RL 算力,回报都稳定、可预测。
官方举了一个例子:在开源人体解剖模型 human-atlas(296 个骨骼部件、402 块肌肉)基础上,团队搭建了包含训练和评估流程的人体行走动力学模拟器,经历 167 个任务、420 次独立评审,让模拟人从几秒内摔倒变为能连续迈步走 11.2 秒。但此后即使训练多轮,性能也没有明显提升。
按以往做法,此时应继续调整奖励函数;月之暗面转而用环境检查平台核查模拟器的动力学,找出并修正了肩部肌肉力臂计算中的 36 处错误,随后重新训练控制器,性能才进一步提升。官方称,这种先怀疑环境而非策略的做法,也体现在模型使用端对工具可靠性的验证上。
网络安全方面,官方披露未做任何防护的内部版 K3.1 Pro 在内部基准 xdev-bench-hard 上得分 90.5%,该基准考查基于源码的漏洞发现与利用,模型需自行写出攻击程序,在隔离沙箱中实现任意代码执行并取得秘密字符串,测试没有严格超时和输出 token 限制。最终发布版本该成绩被削弱至 81.0%,K3 为 33.3%,DeepSeek-V4.1-Flash 为 85.7%。官方表示,这是通用编码和长程调试能力外溢的结果,数据剔除只能压低风险,不能完全阻止模型发现安全漏洞。
定价与版本差异
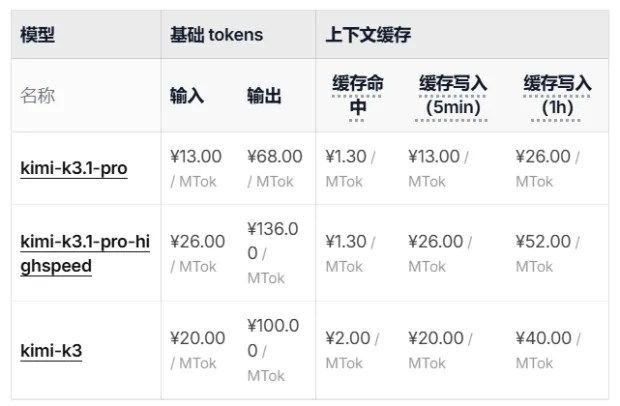
价格方面,K3.1 Pro 输入为 13 元/百万 token,输出为 68 元/百万 token;输入命中缓存时费用降至 1.3 元/百万 token,默认缓存写入为 13 元/百万 token。这一价格低于 K3。
月之暗面同时发布了高速版 K3.1 Pro。官方称高速版在能力、思考档位、上下文和多模态上与标准版一致,差别在于速度提升 2 至 3 倍,价格提高 2 倍,额度消耗也提高 2 倍,其价格高于 K3。
产品策略上也有调整。此前用户关闭 K3 的思考后,输出会自动路由到 K2.8;到 K3.1 Pro,思考强制常开,关闭思考的请求会返回 400。K2.8 曾沿用 K2.7 Code 的模型 ID,老客户端无需改配置即可使用新模型;K3.1 Pro 则更换了整个模型 ID,官方明确提示不要在 K3、K2.8 的旧会话中切换新模型。
背景层面,2025 年底杨植麟在内部公开信里写道,公司短期不着急上市,也不以上市为目的。9 月,月之暗面完成最后一轮私募,估值约 500 亿美元,有媒体报道称其最快本月就会开始与投资者做初步会谈,K3.1 Pro 的发布时间刚好落在这个节点之前。
要点
- K3.1 Pro 为 3T 级开放权重模型,单 token 激活约 1040 亿参数
- 上下文窗口为 100 万 token,权重最晚 11 月 4 日放出
- Terminal-Bench 4.0 得分 65.7%,GPT-6 Astra 为 58.2%
- 幻觉率从 K3 的 23.4% 降至 8.3%
- 输入 13 元/百万 token,输出 68 元/百万 token
正在读取登录状态…
暂无讨论,说说你的看法吧