 Mores
11月5日,月之暗面(Moonshot AI)按照10月24日发布时给出的承诺,在Hugging Face平台开放了Kimi K3.1 Pro的模型权重。该模型采用混合专家架构,总参数量2.8万亿,单次推理激活约1040亿参数,支持约100万Token上下文窗口。
在Arena运营的Agent Arena智能体排行榜中,Kimi K3.1 Pro(Max)位列开放权重模型第一、全部参评模型第13位,并在工作、编程与聊天三个类别中均居开放模型首位。此次排名基于全球用户超过1.75万次真实长周期智能体任务会话。
开放权重的发布
此次权重开放延续了10月24日模型发布时给出的时间表,发布与开放之间相隔约两周。权重文件托管在Hugging Face平台,全球开发者可自行下载,但月之暗面并未同时公布配套的本地部署方案或推理服务。
从公开信息看,Kimi K3.1 Pro延续了Kimi系列以开放权重换取开发者生态的思路。与权重一同受到关注的是模型规模:2.8万亿总参数在已开放权重的模型中处于较高量级,这也直接决定了后续的部署门槛。
Agent Arena评测方式
Agent Arena的评测逻辑与常见的成对盲测不同。它不要求用户对两个模型的回答进行二选一投票,而是从真实用户的智能体会话中提取行为信号,包括用户对任务的明确确认、表扬与投诉、纠正指令,以及Shell命令执行错误等。
这些信号随后交由Arena称为“因果追踪”的随机化推断方法处理,用于估算各模型相对于平均水平的净改进率。换言之,榜单衡量的是模型在真实长周期任务中相对同行的改进幅度,而非单轮问答的偏好得分。
Kimi K3.1 Pro此次的排名基于全球用户超过1.75万次真实长周期智能体任务会话,样本来自实际使用场景而非人工构造的测试集。
排名与分项指标
其净改进率为+5.1%,较上一代K3(Max)的+0.9%提升4.2个百分点。
分项指标显示出更具体的改善。衡量Shell命令执行可靠性的Bash Reliability从K3的-4.5%(第13名)升至+7.9%,在开放模型中排名第一;反映用户满意度的Praise vs Complaint指标从+1.3%升至+7.7%;衡量模型根据用户反馈调整执行方向的Steerability指标达到+6.5%,同样居开放模型首位。
用户明确确认任务完成的Confirmed Success为+3.9%,在开放模型中排名第四。这一项低于前三项,说明模型在让用户主动确认任务闭环方面仍有提升空间。
架构与训练变化
这一激活比例意味着每次推理只调用总参数的一小部分,以控制计算开销。
与K3相比,K3.1 Pro以K3为基座进行了大规模联合强化学习后训练,覆盖数百个下游领域。结构上的另一处调整是将部分全注意力层替换为门控稀疏注意力层,目的是降低长上下文建模的开销。
上述改动与榜单中Bash Reliability和Steerability的提升方向一致,均指向长周期智能体任务中的执行稳定性与反馈响应能力。
部署门槛与基准表现
开放权重并不等于可本地运行。2.8万亿参数以BF16精度存储的权重文件约5.6TB,即使采用INT4量化也仍需约1.4TB,单机消费级显卡基本不具备部署可能。对多数开发者而言,实际使用仍要依赖云端或集群环境。
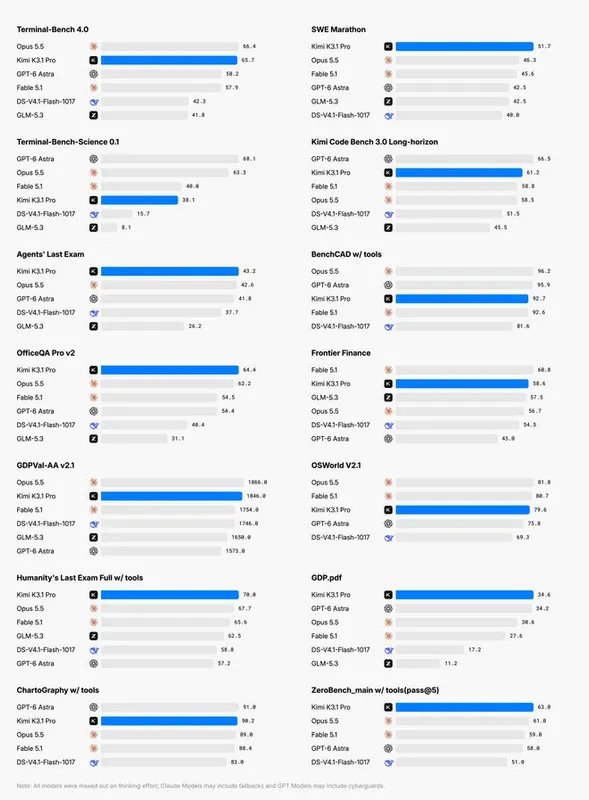
在终端智能体基准Terminal-Bench 4.0上,K3.1 Pro得分65.7%,高于GPT-6 Astra的58.2%,与Claude Opus 5.5的66.4%相差不到1个百分点。这一成绩与其在Agent Arena中偏重命令执行可靠性的表现相互印证。
公开的对比表中还列出多项其他基准,涵盖编程、智能体与多模态等方向,K3.1 Pro在不同项目上的相对位置并不一致,部分项目落后于对比模型。榜单与基准各自反映不同侧面,单一排名不足以概括模型的整体能力。
要点
- Kimi K3.1 Pro权重已在Hugging Face开放
- 总参数量2.8万亿,单次推理激活约1040亿参数
- Agent Arena开放权重模型排名第一,全部模型第13位
- 净改进率+5.1%,较上一代K3的+0.9%提升4.2个百分点
- BF16精度权重文件约5.6TB,INT4量化仍需约1.4TB
正在读取登录状态…
暂无讨论,说说你的看法吧