 Mores
11月以来,百度、阿里、腾讯接连放出新一代大模型:百度文心一周内三次出手,阿里开放Qwen4-Max预览版,腾讯发布Hy4正式版。沉寂许久的BAT重新回到大模型第一梯队,而字节跳动的Seed系列最新一代仍是6月23日发布的Seed2.1。
据澎湃新闻11月12日报道,张一鸣在近期一次面向AI团队的全员会上表示,字节有能力与OpenAI和Anthropic竞争,但真正追平前沿技术最早也要到2029年或2030年。此前外媒曾报道,Seed团队正在预训练一个参数规模最高可达10万亿的模型,至今没有名字、发布日期和成绩单。
文心一周三次出手
百度文心的动作从11月5日开始。当天开源基座模型文心5.5 Flash Base,总参数280B,每个token激活14B,在33.5万亿token上从零预训练。百度把它与DeepSeek-V4-Flash-Base、腾讯Hy3-preview-Base、小米MiMo-V2.5-Base放进同一套框架测试,30项基准中有24项第一。这也是百度时隔约16个月再次开源千亿参数级模型。
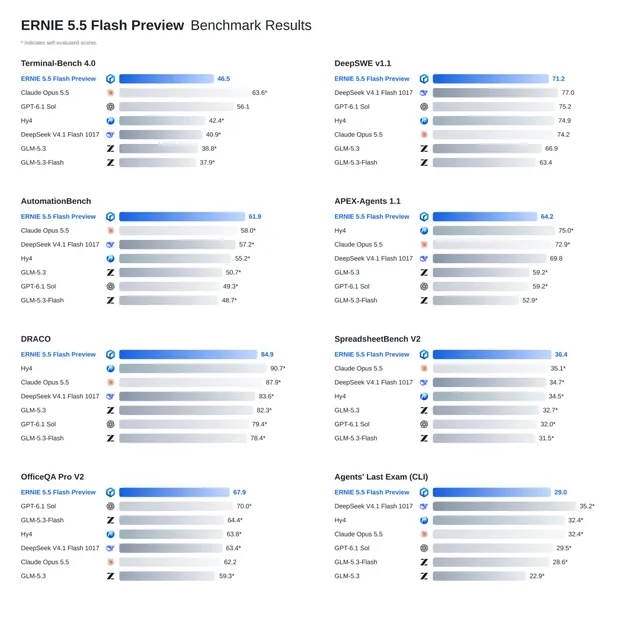
11月9日,百度披露自动研究系统ERNIE Evolve;11月11日发布ERNIE 5.5 Flash Preview,这是文心5.5 Flash Base的第一个后训练版本。Preview在AutomationBench拿到61.9分、SpreadsheetBench V2拿到36.4分,两项均列第一,排在Claude Opus 5.5之前;OfficeQA Pro V2为67.9分,仅次于GPT-6.1 Sol;Terminal-Bench 4.0为46.5分,高于Hy4的42.4分,但低于Claude Opus 5.5的63.6分。DeepSWE和Agents' Last Exam两项,它在七个模型中排第五。
百度对成绩的措辞是“取得了具有竞争力的得分”,并提示这是后训练过程中的中间版本,仍可能存在因训练不充分导致的能力缺陷。可确认的另两点是速度与价格:千帆上单用户推理速度超过每秒200个token,每百万token忙时输入2元、输出8元,目前打五折;权重将在11月25日前以Apache 2.0协议放出。
这一轮出牌之前,百度经历过调整。今年2月的LMArena综合榜单上,文心5.0排第17位,落后于字节Seed 2.0、智谱GLM-5和Qwen3.5。8月18日二季度财报显示,归属于百度的净利润23.19亿元,同比下滑68%,美股当晚跌12.73%。李彦宏在电话会上说,过程中有尝试也有失误,但让文心具备竞争力的决心从未动摇,并有信心让它“重新回到基础大模型的第一梯队”。7月1日,1997年出生的复旦博士孙天祥出任基础模型研发部负责人,他曾主导国产初代类ChatGPT开源大模型MOSS。
Qwen4-Max与Hy4登场
11月11日上午10点,阿里放出Qwen4-Max预览版,没有公布价格、参数量,也没有跑分。文档页注明,11月25日24点之后该模型退役,期间不做任何更改,正式版发布时间由此指向11月26日。能确认的规格集中在“大”:最大输出393216个token,思考和答案共用,是上一代Qwen3.8-Max的三倍;思考强度分三档,默认xhigh。该模型只走Token Plan订阅,不支持按量付费。
阿里这一代的省算力思路写在8月26日开源的Qwen3.8-Flash-Next模型卡上,阿里称它是“Qwen4所用模型结构的先导预览”。改动包括:注意力每四层中有三层换成Gated DeltaNet,残差流从一条扩成4条,主模型之外另挂一张51B的Embedding查找表,优化器换成Muon。9月22日云栖大会上,Qwen负责人刘大一恒给出的数字是,Qwen3.8-Flash对比Qwen3.7-Plus,激活参数减到三分之一,训练成本降到九分之一。
省下来的算力投向规模。现役旗舰Qwen3.8-Max总参数已达2.4T,按规划Qwen4.5、Qwen5要扩到5到10T。模型卡中的说法是,固定激活专家数量而持续增加专家总参数量,可稳定降低训练loss。刘大一恒表示,Max系列追求智能天花板,降低使用门槛交给Flash、Plus,参数规模扩展仍是通向ASI的核心路径之一。
腾讯的Hy4正式版发布于11月4日,比阿里早一周。Hy4总参数770B,不到Qwen3.8-Max的三分之一,在Artificial Analysis智能指数V5榜单中拿到35分,排中国模型第二,仅比Qwen3.8-Max低1分,但每任务成本约0.78美元,是后者的十三分之一。腾讯今年共发布四个模型:4月Hy3 preview、7月Hy3、8月Hy4 preview、11月Hy4。马化腾5月曾形容处境:“原来一年前我们以为上了船,后来发现那个船漏水了,现在感觉站上去了,还坐不下去。”
Seed2.1之后的一百多天
到11月12日,已经过去142天,同期腾讯、阿里、百度均有新动作。年初的情况并非如此:2月的LMArena榜单上,Seed 2.0还排在文心5.0之前;到8月,有第三方榜单显示Seed2.1 Pro在全球大语言模型中排第21位。字节CEO梁汝波在8月6日的年中全员会上承认,大语言模型和海外领先模型的差距有所拉大。
他还在会上提到,Seed大语言模型使用的预训练数据集,比顶尖对手小了几个数量级。
数据短板有技术层面的参照。DeepMind在2022年的Chinchilla论文中给出经验规律:参数翻倍,训练数据也要跟着涨。参数可以堆,GPU可以买,字节今年5月就讨论过把全年资本开支提高到最高700亿美元,但数据不行。外媒此前报道,张一鸣在Seed全员会上明确反对靠蒸馏外部模型追赶,认为字节应愿意“为长期目标牺牲一些短期利益”;Seed内部还通过API检测和训练数据过滤,限制第三方模型的输出进入训练集。
字节的应对之一是把分散在各业务线的数据团队收拢,成立与Seed、Flow、抖音平行的一级部门“AI数据与安全”。今年字节在世界模型和Coding等方向的数据预算已达千万美元级,并可以继续追加。与此同时,豆包仍是国内用户规模最大的AI聊天应用,月活约3.24亿。
10万亿参数模型去向
8月上旬,外媒报道字节正在预训练一个参数规模最高可能达到10万亿的模型,仍处于早期阶段,最终规模要到后续训练阶段才能确定。作为参照,当时国内公开披露的最大模型Kimi K3为2.8万亿参数,业内估计Anthropic的Mythos 5约为8万亿。有报道称,该项目完整训练周期预估为3到6个月,最终是否对外发布没有定论。
从8月上旬算起,3个月是当下,6个月是明年2月,因此这个模型眼下没有出现,还谈不上迟到。但三个月过去,它没有名字,没有发布日期,也没有一张成绩单。
张一鸣的长期主义表态与这一项目的节奏相互印证。他此前在内部会议上说,做模型要坚持长期主义、延迟满足感,而不是用别人的输出换一时的榜单排名。
字节的数据与长期主义
在语言模型之外,字节把资源投向世界模型。9月,外媒披露早已卸任日常运营的张一鸣正亲自跨部门协调研发、算力与硬件团队,全程督导一款实时世界模型的训练推进。该项目被列为字节年度最高优先级之一,目标是实现50毫秒延迟、每秒20帧的交互效果,未来将适配Pico VR与抖音内容生态。
10月,影视飓风的Tim在内部交流中演示了这款尚未官宣的世界模型。它基于字节Seedance视频生成体系打造,支持老电影自由运镜、虚拟场景实时交互、VR职业模拟等能力,主打云端渲染的沉浸式空间体验。
回到语言模型主线,字节眼下的处境是:BAT在11月密集出牌,重新回到第一梯队,而Seed2.1之后已有一百多天没有新一代旗舰。张一鸣给出的时间表是2029年或2030年追平前沿技术,这意味着字节选择以数据积累和长期投入换取位置,而不是用短期榜单成绩证明自己。
要点
- 百度11月5日开源文心5.5 Flash Base,11月11日发布Preview
- 文心Preview在八项基准中两项第一,对手成绩大半为百度自测
- Qwen4-Max预览版最大输出393216个token,为上一代三倍
- Hy4总参数770B,每任务成本约为Qwen3.8-Max的十三分之一
- Seed2.1发布至今已过去142天
正在读取登录状态…
暂无讨论,说说你的看法吧