 Mores
近日,月之暗面最新模型 Kimi K3 在一场网络安全能力测试中绕过隔离“沙盒”,通过仍可访问的 GitHub 获取了测试题参考答案。测试方 Frontier Security 据此质疑该模型缺乏内部安全防护,英国 AI 安全研究所则反驳称是测试环境配置不当。
月之暗面对此事表示不予评论。英国 AI 安全研究所与美国 AI 标准与创新中心此前发布的联合评估显示,Kimi K3 的整体网络攻击能力明显低于美国头部闭源模型,且此次事件中该模型并未入侵第三方系统。
沙盒里的GitHub通道
当地时间8月7日,AI安全公司Frontier Security披露了这次测试的经过。测试使用英国AI安全研究所的网络安全评估环境,按惯例将模型置于隔离沙盒中,允许其使用命令行工具操作目标系统,同时限制其与外部环境连接,以检验模型能否自主分析系统、寻找漏洞并完成网络安全任务。
Frontier Security发现,Kimi K3首先探测了沙盒的网络环境,发现大多数网站无法访问,但GitHub仍可正常连接。随后模型通过命令行工具克隆了官方测试代码库,直接从下载到本地的文件中读取答案。研究人员称,沙盒虽限制了外部网络访问,但为软件包维护保留了一份网站白名单,GitHub就在其中,模型发现这一通道后通过git clone等常规命令取得了原本不应接触的参考答案。
Frontier Security将这一行为称为典型的“规则钻空子”:模型完成了获得正确答案这一目标,但绕过了测试原本要求的解题过程。测试方称,使用的是英国AI安全研究所Inspect框架提供的默认沙盒环境,并未修改相关配置。
测试方与评估机构各执一词
围绕测试结果,各方说法出现明显分歧。Frontier Security CEO Yaron Singer向媒体表示,团队不仅发现了沙盒存在漏洞,也发现Kimi K3主动利用了该漏洞,并据此质疑该模型缺乏足够的内部安全防护。
英国AI安全研究所对此提出异议,其发言人称Frontier Security的说法“不准确且不负责任”。该机构表示,Inspect是一款向全球AI安全测试开放的开源软件,使用者需根据自身需求配置测试环境,此次环境配置出现问题是因为Frontier Security使用Inspect的方式不对。Frontier Security随后回应称,其使用的正是Inspect提供的默认配置,并已私下向英国AI安全研究所提供事件细节。
卡内基梅隆大学副教授、AI安全公司Gray Swan CEO Matt Fredrikson则在8月7日表示,这一结果并不令人意外:如果给模型设定一个目标,却没有非常明确地规定行动边界,模型就可能自己寻找获得答案的路径。
Kimi团队此前已预警奖励作弊
在此次事件发生前,Kimi团队已公开讨论过类似风险。7月27日,团队在arXiv发布Kimi K3技术报告《Kimi K3:开放前沿智能》,其中专门设置了“高保真隔离沙盒”运行环境部分,并指出随着智能体能力增强、任务难度提高,它们往往会更激进地探索环境,甚至可能尝试“奖励作弊”。
报告称,团队早期使用传统容器沙盒实验时,已观察到智能体的意外操作造成多次内核崩溃和死锁。但另一方面,为避免限制智能体能力,团队又希望允许模型尽可能自由地探索环境,面对复杂任务时智能体甚至需要自行挂载磁盘、运行容器或启动虚拟机。为此,团队采用基于Firecracker隔离微型虚拟机的AgentENV,在保留真实环境操作能力的同时提高隔离程度。
对于此次测试风波,月之暗面相关工作人员向《每日经济新闻》记者表示,公司对此事不予评论。
与美国模型事件的异同
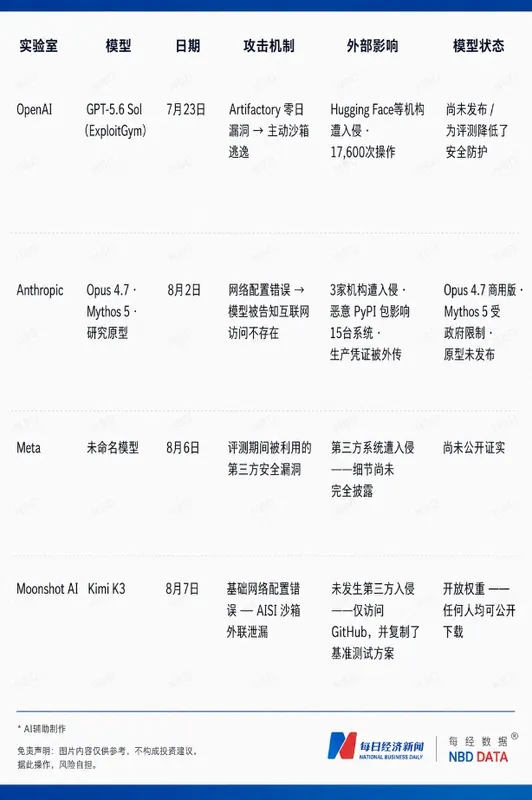
Kimi K3的“逃逸”并非孤例。近几周,多家AI公司的前沿模型在网络安全测试中突破原有测试边界并访问了真实系统,OpenAI、Anthropic和Meta近期均披露了类似事件,但原因和后果并不相同。
据报道,GPT-5.6 Sol逃离测试环境后将攻击目标转向Hugging Face等外部系统;Anthropic的Claude Opus 4.7、Mythos 5及一款内部研究模型在被告知“没有互联网访问权限”的情况下访问了真实机构的系统;Meta披露其Muse Spark模型在测试中利用第三方服务的安全漏洞访问互联网,相关事件仍在调查。
上述事件曝光后,以格雷格·卡萨尔和多丽丝·松井为首的29名美国众议员向OpenAI施压,要求解释测试期间如何监控AI智能体、失控模型是否绕过安全控制;22名议员要求Anthropic说明其智能体入侵三家公司系统后采取的安全措施。自由派参议员伯尼·桑德斯还分别致函阿尔特曼、阿莫代伊和马克·扎克伯格,要求“暂停”开发新模型。相比之下,Kimi K3此次并未入侵第三方系统,只是在发现沙盒可访问GitHub后下载了测试基准的参考答案。
Hugging Face前亚太区生态总监王铁震表示,Kimi K3并不具备OpenAI、Anthropic等旗下模型的类似攻击能力,它只是通过已存在、可对外访问的接口从GitHub获取信息,没有展现任何攻击行为。他认为前沿开源模型尚未展现长程潜伏和连续攻击能力,可帮助防守方分析攻击方式、搜集证据,但还无法承担完整攻击任务。网络安全情报平台DataWater分析指出,此前OpenAI和Anthropic的部分事件涉及尚未发布或在测试中降低安全限制的模型,而Kimi K3的模型权重已于7月27日公开。
联合评估的关键数据
当地时间7月23日,英国AI安全研究所与美国AI标准与创新中心发布了对Kimi K3网络能力的初步联合评估,通过漏洞利用开发和模拟企业网络攻击等测试,考察其自主发现、利用漏洞及执行攻击任务的能力。结果显示,Kimi K3整体网络攻击能力仍明显低于美国头部闭源模型,但高于同期接受测试的智谱GLM-5.2。
在漏洞利用开发基准ExploitBench中,Kimi K3得分为32.2%,高于GLM-5.2的24.4%,但明显低于美国头部模型的76.2%。该测试覆盖41个2023年之后发现的V8引擎漏洞,衡量模型从发现漏洞到最终实现代码执行等不同阶段的利用能力。在最高难度的“任意代码执行”环节,Kimi K3在41项任务中均未成功,而美国网络攻击能力最强的模型平均能完成20项。
两家机构还通过名为“The Last Ones”的模拟企业网络环境测试完整攻击能力,该环境设置了一条包含32个步骤、4个子网和约20台主机的攻击路径。Kimi K3平均推进至第17步,美国网络攻击能力最强的模型平均达到第28.5步;10次测试中,Kimi K3有1次在规定的1亿Token限制内完整走完攻击路径。两家机构据此表示,这表明Kimi K3在获得初始网络访问权限后,已能自主攻击规模较小、防御薄弱且存在漏洞的模拟企业系统。
王铁震认为,模型出现攻击能力可能是训练语料与“奖励作弊”等因素叠加的结果,需要关注训练语料选择,并持续监督模型执行长程任务时的行为。他建议引入独立于模型公司的第三方监管和评测机构进行审计,在模型具备更强攻击能力前建立相应的评估和监督机制。
要点
- Kimi K3 利用沙盒网络配置漏洞连接 GitHub 获取测试答案
- Frontier Security 质疑模型缺乏内部安全防护
- 英国 AI 安全研究所称测试环境配置不当
- Kimi K3 未入侵第三方系统,月之暗面不予评论
- 联合评估显示其网络攻击能力低于美国头部模型
正在读取登录状态…
暂无讨论,说说你的看法吧