 Mores
清华大学与智谱AI联合完成的一篇论文披露了智谱内部模型GLM-Omni的技术细节,唐杰担任通讯作者。论文并未说明该模型对应哪个产品版本,但给出了它在统一视觉理解与图像生成方面的一组实验结果。
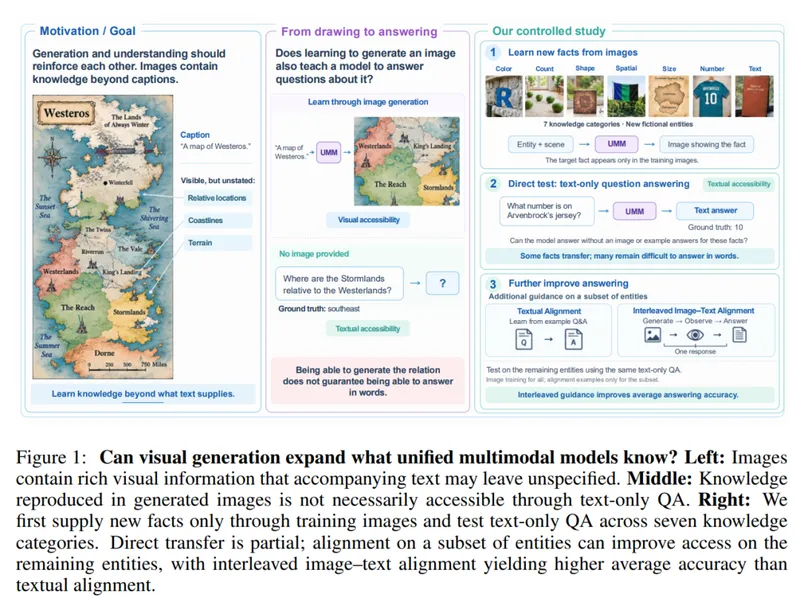
研究团队搭建虚构世界MagicWorld,用受控知识测试三种多模态模型。结果显示,模型在图像生成中复现知识的正确率明显高于纯文字问答,GLM-Omni分别为54.00%和14.57%,说明图像里学到的内容并不一定能被语言推理调用。
虚构世界测试设计
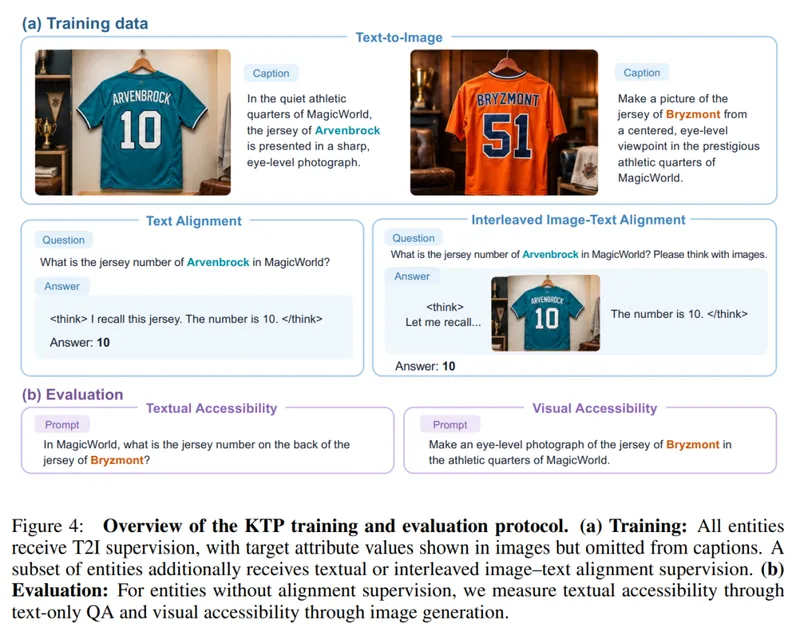
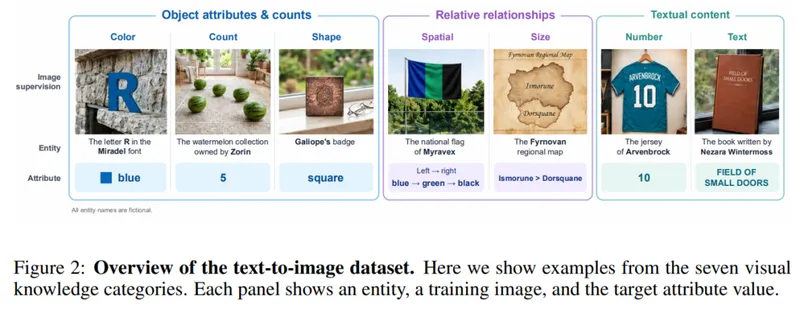
为避免模型依靠训练语料中已有的记忆作答,研究团队搭建了虚构世界MagicWorld,为从未存在过的实体安排颜色、号码和空间关系,使目标知识尽量只通过本次训练的图像进入模型。论文举例说,一件虚构球衣名为Arvenbrock,号码设为10,训练时的文字提示只要求生成这件球衣,数字10仅出现在目标图像中;训练结束后再直接询问该球衣的号码,若模型能答出10,才有理由认为它把图像中的实体属性带入了文字回答。
这套数据覆盖颜色、数量、形状、空间排列、相对大小、数字和文字7类任务,每类50条知识,共350条。团队为每个实体制作不同背景和视角的图像,筛选后保留8552组训练样本,并对训练文本进行检查,尽量排除答案泄漏和属性分布不均的干扰。不同任务对应不同的知识类型:形状与颜色多属有限类别,空间排列要求理解对象之间的位置关系,球衣号码和书籍标题则需要记住具体的字符序列。
测试分为两条路径:一条让模型重新生成目标图片再检查图中属性,衡量生成过程能否复现关联;另一条不提供图片,只用文字提问,衡量关联能否直接转为语言答案。参与实验的三种模型架构不同:BAGEL将理解和生成放在相对独立的专家分支中,SenseNova-U1直接建模图像像素,GLM-Omni则从GLM-4.1V-Thinking预训练模型出发,接入基于X-Omni的离散图像Tokenizer。研究还加入10000条与目标知识无关的文字问答,让模型熟悉回答形式而不提前获得答案。
会画却不会说
实验结果显示出普遍差距。BAGEL的平均视觉正确率为31.43%,文字回答仅8.86%;GLM-Omni分别为54.00%和14.57%;SenseNova-U1为61.14%和20.00%。在数字任务中,把指定号码正确画在球衣上的比例达到72%,研究人员拿走图片、改用文字询问球衣号码时,正确率却只有2%。SenseNova-U1在号码任务中的视觉正确率甚至达到88%,纯文字回答为0%。
论文对此的解释是,图像生成的训练目标是让模型根据名称和提示重建视觉内容,只要实体与属性的关联有助于还原图片,就能在训练中得到强化;文字问答则还要沿语言输出路径找到对应属性,并把它变成字符或词语。共享参数并不意味着这些路径已经互相打通。此外,部分知识连生成路径也未学稳,例如BAGEL与SenseNova-U1在空间排列任务中的视觉正确率均为0%,因此后续训练需要区分学习不足与读取困难。
图文交错训练
团队先尝试Textual Alignment,为部分实体补充文字问答,观察模型能否从少量样例学会读取同类视觉属性。每类50个实体平分为两组,全部接受图像生成训练,其中25个实体各获得10条文字问答示例,其余25个不提供文字答案、留作测试。结果显示分化明显:BAGEL平均文字正确率从8.86%升至15.43%,SenseNova-U1从20.00%升至28.00%,GLM-Omni却从14.57%降至12.57%。SenseNova-U1的形状任务从20%增至68%,相对大小达到100%,但三种模型在测试实体的数字与书籍标题任务中正确率仍为0%。
研究认为,形状、大小有可迁移的分类和比较规则,其他实体的问答示例能提供帮助;号码和书名则需要对应每个实体独有的字符,仅学会回答句式远远不够。更关键的是,图像生成与文字问答仍被拆成两种训练样本,模型分别学会画图与作答,却没有在同一条响应中练习从视觉内容走向语言答案。
Interleaved Image–Text Alignment(图文交错对齐)由此提出,把图像生成和文字回答放进同一条训练序列:碰到球衣号码问题,模型先生成对应球衣,再根据画面里的号码组织文字答案。评估条件并未改变,测试时仍要求直接文字回答,不能临时生成图片。GLM-Omni的平均文字正确率由文本对齐阶段的12.57%提高到26.86%,形状任务从12%升至64%,空间排列从0%升至40%;BAGEL和SenseNova-U1的平均值也分别达到17.14%与28.57%。不过部分颜色和数量任务出现回落,交错训练尚无法兼顾每种视觉属性。
为判断提升来自图像监督还是仅增加了文字推理内容,团队在GLM-Omni上做了消融:保留同样的交错响应、文字监督与独立图像生成训练,只屏蔽交错样本中的图像损失,平均文字正确率随即从26.86%跌到13.71%。这说明图像重建的训练信号确实对语言调用产生了影响。至于模型通过哪些参数共享这些信息,实验尚未定位。
先画再答的取舍
既然模型更擅长把答案画出来,研究团队尝试在回答前先画一遍。Visual Chain-of-Thought(Visual CoT)允许推理过程中生成目标图像,再从图像中识别属性,最后回答文字问题。GLM-Omni的平均正确率从26.86%升至41.14%,BAGEL从17.14%升至20.57%,SenseNova-U1从28.57%升至34.86%。数字任务的改善更明显:三种模型原先直接文字回答的正确率均为0%,使用Visual CoT后分别达到4%、36%和20%。论文中的一个案例里,SenseNova-U1直接回答球衣号码时给出错误的69,生成球衣图像再读取后答出了正确的31。
这一路线也带来取舍。生成图像可以成为知识检索的中间载体,但需要额外计算,若图像内容出错,答案还可能被带偏。书籍标题任务在Visual CoT下依然没有改善,复杂字符的生成和读取仍存在困难。此外,实验知识来自受控的虚构世界,这条路线在真实动态场景中的效果还有待进一步检验。
统一架构的难题
GLM-Omni随论文露面,让智谱在统一视觉理解与生成方向上的内部探索有了具体的技术细节。论文并未说明该模型对应哪个产品版本,社交平台上有人将其与GLM-5.5联系起来,但版本对应关系尚无公开信息。研究中的几轮实验则把一个长期被生成效果掩盖的问题摆了出来:模型通过图像学到的东西,并不一定能直接用于语言回答。
图文交错训练改善了部分知识的跨模态连接,Visual CoT则让模型在需要时借助生成图像重新读取信息。对于继续走向统一架构的多模态模型,接下来的难题除了把图画好、把问题答对,还包括怎样让不同任务积累的知识有效互通。至于GLM-Omni是否会进入某个后续产品版本,仍需更多公开信息。
要点
- 论文由清华大学与智谱AI联合完成,唐杰为通讯作者
- MagicWorld共设计7类任务、350条知识,筛选后留下8552组训练样本
- GLM-Omni图像生成平均正确率54.00%,文字回答14.57%
- SenseNova-U1视觉正确率61.14%,文字回答20.00%
- 图文交错对齐后GLM-Omni文字正确率升至26.86%
正在读取登录状态…
暂无讨论,说说你的看法吧