 Mores
10月30日晚间,国产GPU厂商沐曦股份发布2026年三季报。公司前三季度营收28.24亿元,同比增长128.45%;归母净利润6.39亿元,扣非归母净利润2.59亿元,同比实现扭亏。
单看第三季度,沐曦股份营收达到15亿元,超过上半年总和,扣非归母净利润3.08亿元,已连续两个季度扣非盈利。公司同时推出限制性股票激励草案,将营收规模与新增发明专利申请量设为考核指标。
业绩与季度表现
三季报显示,沐曦股份前三季度归母净利润为6.39亿元,扣非归母净利润2.59亿元,与上年同期相比实现扭亏。营收增速达到128.45%,在国产GPU厂商中处于较快水平。
第三季度的表现尤为突出。单季营收15亿元,超过上半年营收总和;扣非归母净利润3.08亿元,公司已连续两个季度保持扣非盈利。来源将这一变化概括为商业化和盈利改善信号明确。
从前三季度的整体数据看,营收翻倍与利润转正同时出现,意味着公司此前的投入正在转化为可确认的收入,亏损压力有所缓解。
订单落地与产品矩阵
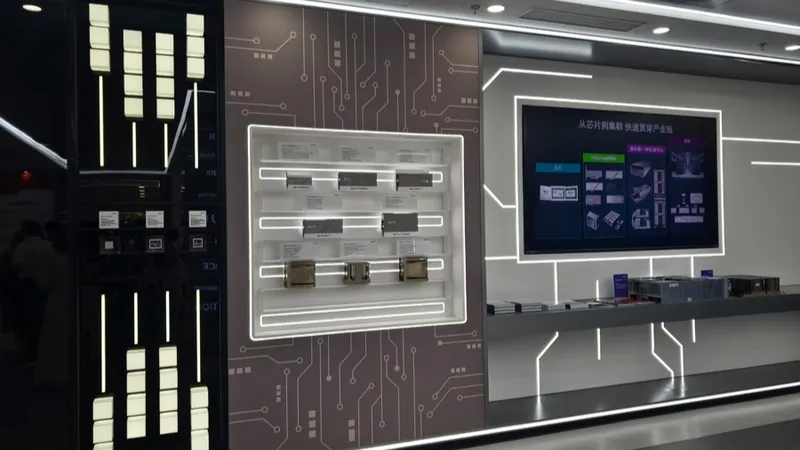
业绩走高的直接支撑来自GPU产品订单持续落地。来源提到,今年5月曦云C600量产上市,补齐了公司高性能GPU产品矩阵,并依托全国产供应链实现稳定交付,为市场拓展提供产能与供货保障。
产品线的完善与交付能力的稳定,是订单转化为营收的前提。来源未披露各产品线的具体收入构成,仅将订单落地与C600量产列为业绩增长背后的主要因素。
算力需求与行业背景
行业层面的需求扩张为国产GPU提供了市场空间。智能体等AI应用快速普及,带动算力调用量攀升。中国信通院数据显示,截至2026年6月,国内日均Token调用量突破500万亿。
来源同时指出,AI算力投资逻辑正在发生变化,市场关注点从硬件投入规模转向投资回报。这一转变使GPU竞争的焦点从单卡性能比拼,转向系统级算力效率,对厂商的软硬件协同能力提出更高要求。
系统级算力布局
围绕系统级效率,沐曦在硬件、高速互连与软件栈三个层面同步布局。在今年WAIC上,公司推出曦景S系列超节点以及面向科学智能的曦索X300系列。其中曦景S600可横向扩展至万卡集群,用于降低多卡通信延迟。
软件方面,配套的MXMACA软件栈已迭代至3.9.0版本,相关KV Cache技术代码并入开源项目LMCache。公司还完成了智谱GLM、千问、混元等主流大模型的快速适配。
落地案例上,沐曦与魔形智能合作的万卡级“Token超级工厂”已经投产。依托软硬件协同能力,该集群从就绪到模型上线仅需1至2天,缩短了大规模算力部署周期。来源称,随着算力建设更看重集群效率与部署成本,这套全栈方案仍将持续接受大规模生产场景的检验。
股权激励考核目标
在发布三季报的同时,沐曦推出限制性股票激励草案,将营收规模与新增发明专利申请量共同设为考核指标,既锁定经营目标,也鼓励持续研发创新。
营收考核的具体设定为:2027年营收不低于60亿元;2027年至2028年累计营收不少于150亿元;2027年至2029年累计营收不低于300亿元。来源认为,这一安排意在绑定核心团队的长期发展。
要点
- 前三季度营收28.24亿元,同比增长128.45%
- 扣非归母净利润2.59亿元,同比扭亏
- 第三季度营收15亿元,超过上半年总和
- 曦云C600于今年5月量产上市
- 激励草案设2027年营收不低于60亿元
正在读取登录状态…
暂无讨论,说说你的看法吧