 Mores
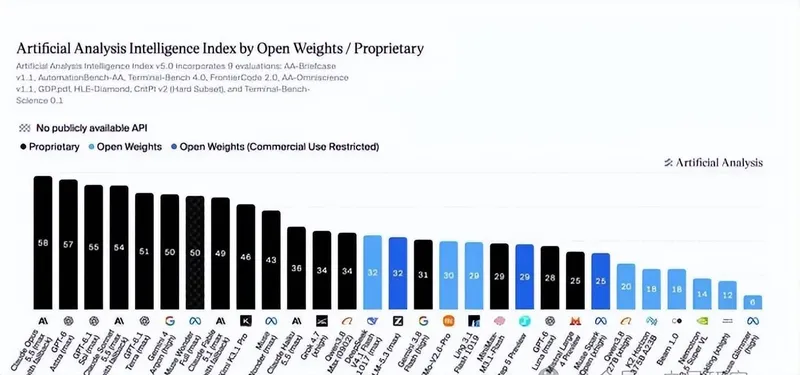
2026年10月26日,评测机构Artificial Analysis将智能指数升级到第五版,几天内国产开源模型在全球榜单上的排位明显下滑。Claude Opus 5.5以58分登顶,前五名均为美国闭源模型;月之暗面Kimi K3.1 Pro以46分成为开源阵营唯一进入前十的模型。
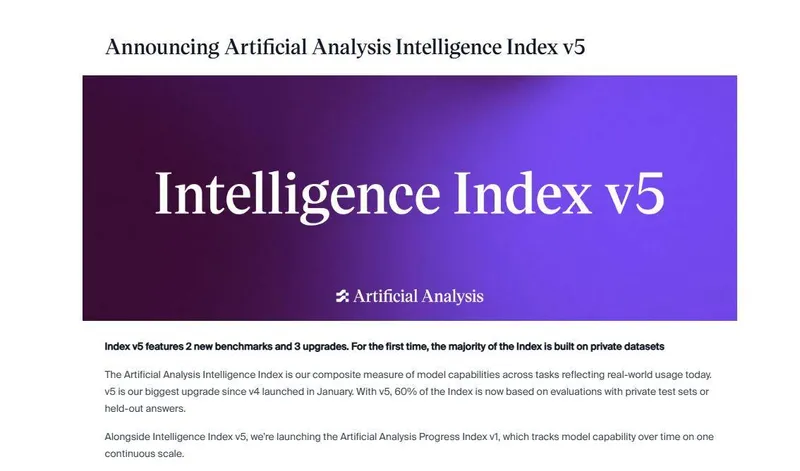
新版评测将私有测试集占比从约45%提高到60%,并新增真实代码仓库与终端科研工作流两项基准。开源与闭源头部的分差由上一代的3分扩大到12分,引发关于国产模型真实能力的讨论。
榜单排名变化
按第五版智能指数,Claude Opus 5.5以58分登顶,GPT-6 Astra以57分紧随其后,GPT-6.1 Sol为55分,Gemini 4 Argon为50分,前五名全部由美国闭源模型占据。开源阵营中排名最高的是月之暗面的Kimi K3.1 Pro,46分,也是唯一进入前十的开源模型;不过其权重尚未发布,严格意义上只能算预备开源。
分差的变化更受关注。上一代v4.3版本中,开源与闭源头部的差距只有3分,到v5版本扩大到12分。排名下滑发生在指数升级后的几天之内,也正因如此,外界对国产模型真实能力的讨论迅速升温。
评测规则改了什么
v5版最直接的变化是私有测试集占比提高。上一代私有数据占比约为45%,新版提高到60%,上升15个百分点。私有题目的题目与答案均不对外公开,模型无法提前针对题目做调优,这对依靠公开基准做针对性训练的团队影响较大。
评测维度的权重也被重排。旧版四大板块中,通用能力和智能体各占三成,编码与科学推理各占两成;新版改为四等份,知识工作、编码、科学、通用各占25%。原来的智能体被并入知识工作,科学推理则扩展为范围更广的科学。
新版还新增两项基准:Cognition的FrontierCode 2.0考察模型在真实代码仓库中修改代码、并看维护者是否愿意合并;Terminal-Bench-Science 0.1则把模型放入终端环境,要求跑完整的科研工作流。真实场景与科研能力在总分中的分量因此明显上升。
科研基准上的差距
领先的闭源模型大约能跑完六成任务,Claude Opus 5.5、GPT-6 Astra等均在前列;而大多数国产开源模型的得分只有10%上下,差距达到一个数量级。
这一短板与资源投入方向有关。过去国内厂商在算力获取上偏紧,高端芯片和训练集群不易凑齐,高质量数据建设起步较晚,专业领域标注尤为困难。据流出的一份投资者纪要,DeepSeek创始人梁文锋谈到与海外前沿模型的差距时专门提到高质量数据标注,称团队里一半研究员都投入在标注工作上,要较好解决这一问题还需约一年时间。
2026年年初,行业筹码集中在AI编程和智能体方向,Anthropic正是靠编程能力完成对OpenAI的阶段性反超。GLM-5.3、Kimi K3、DeepSeek V4也把编程能力打磨得较为突出,今年夏秋全球开发者在真实Coding场景中对其性价比有所认可,部分调用从Claude和GPT分流。代价是通用模型在科研方向的预训练和后训练被放到次要位置,生物医学、基础物理、复杂科学工作流所需的跨学科数据、专业评测集和实验室对接,在国内生态中尚未形成闭环。
业内与厂商说法
Anthropic战略层的迪恩·鲍尔公开表示,v5的排名第一次大致符合他的主观判断。这一表态被外界视为行业内部对公开基准与真实能力之间落差早有判断的旁证。
长期研究开源模型的内森·兰伯特则提醒,开源模型的衰落被放大得有些过头,一把尺子衡量不了所有场景。他还指出,私有测试集虽然挡住了背题,却让外界更难审计评测机构自身的独立性,长远看是另一种风险。
支持国产开源模型的一方也有实据:GLM、Kimi、DeepSeek在全球开发者社区已有积累,Hugging Face上的下载量和部署案例是榜单之外的实际使用证据。在编程、长上下文、中文理解和性价比方面,这些模型仍保有优势。
另有一项测试可作参照:Aikido八月的网络安全漏洞挖掘测试中,DeepSeek V4 Pro 0813在32个真实CVE中挖出28个,成绩超过Opus和Sol。
争议与后续影响
围绕这轮排名震荡,网上出现工业化蒸馏、刷榜过拟合、高调营销等旧账重提的声音,认为国产模型现了原形;也有观点认为模型本身没变,变的是量尺,考题、考法和阅卷逻辑都换了,原本靠公开题库练出高分的模型在闭卷新题前露怯并不意外。
赛场焦点也在移动。Anthropic招股书估算全球生物医药市场体量约2万亿美元,OpenAI、Anthropic、谷歌DeepMind都在向湿实验室闭环投入,让AI跑真实实验、让机器人动手操作。谷歌新推出的Gemini 4 Carbon重夺榜首,依靠的正是数学和科学基准上的表现。
有分析认为,科研闭环加上AI递归式自我迭代可能成为贯穿2027年的主线。若AI能跑顺假设生成、实验执行、结果反馈这条链条,就能加速下一轮技术迭代。对国产阵营而言,需要补的功课从算力延伸到数据和评测体系,而编程与性价比上的既有优势不会因换尺子而消失。
要点
- Claude Opus 5.5以58分登顶新版智能指数
- Kimi K3.1 Pro以46分位列开源阵营最高
- 私有测试集占比由约45%提高到60%
- 开源与闭源头部差距由3分扩大到12分
- 多数国产开源模型在科研终端基准得分约10%
正在读取登录状态…
暂无讨论,说说你的看法吧