 Mores
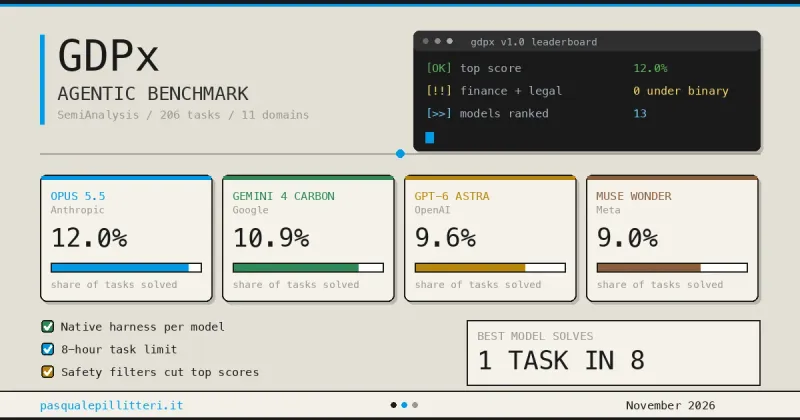
美国研究机构 SemiAnalysis 于 2026 年 11 月 2 日发布 AI 智能体基准测试 GDPx,首份榜单显示表现最好的模型只完成 12.0% 的任务,拿下榜首的是 Anthropic 的 Claude Opus 5.5。Google 的 Gemini 4 Carbon 以 10.9% 居次,OpenAI 的 GPT-6 Astra 以 9.6% 排第三。
测试共 206 项任务,覆盖从芯片设计到金融的十一个行业,参测的十三个模型里没有一个摸到总量的五分之一。该基准由 SemiAnalysis 创始人 Dylan Patel 等人署名发布,意在衡量智能体能在多大程度上独立完成真实的专业工作。
GDPx 测的是什么
GDPx 试图回答的问题是智能体能否独立完成真正的专业工作,而不是能否答对一道编程题。入选的十一个领域包括芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进、硬件设计、材料科学、对齐和软件工程。公共部门、房地产和保险被明确排除在外,发布方给出的理由是,AI 的第一笔万亿美元收入会集中在前沿智能立刻见效的行业,而非对 GDP 贡献最大的行业。
每个领域由一家专业合作方负责出题。芯片领域是 Aria、Arcverex 和 Ergodex,网络安全是 Arithmetic,生物是 Latch Bio,金融是 Living Context,法律是 Chakra,交易是 Third Moment,自我改进是 Extrapolate,硬件是 Beautiful Machines,材料是 ValenceForge 和 Emulated,对齐是 Fleet,软件是 Datacurve。单项任务时限最长八小时。
运行方式也按各家工具的真实用法安排:有原生环境的模型就在原生环境里跑,Opus 5.5 用 Claude Code,GPT-6 Astra 用 Codex,Gemini 4 Carbon 用 Antigravity,其余模型退回 OpenCode。发布方承认这样对比不够整齐,但更贴近付费用户的实际使用场景。
榜单与成本对比
总分对每个领域一视同仁,取三次尝试的平均值。除前三名外,Meta 的 Muse Wonder Full 以 9.0% 排在第四,Z.ai 的 GLM 5.3 以 2.7% 位列第十三。
成本数据改变了榜单的读法。Opus 5.5 单项任务平均花费 51.41 美元,Gemini 4 Carbon 为 16.29 美元,GPT-6 Astra 为 53.99 美元。夺冠的 Opus 5.5 单项花费是 Gemini 4 Carbon 的三倍多,平均消耗 548,000 个输出 token。SemiAnalysis 把 GPT-6 Luna 和 DeepSeek 划入投入产出比的低档,Opus 在高档,OpenAI 居中。
拆到具体行业,格局就分散了。Opus 5.5 拿下交易、硬件设计和芯片,Gemini 4 Carbon 夺得生物,并在软件领域以微弱优势领先,GPT-6 Astra 则包揽自我改进和材料。Meta 的 Muse Wonder 六月发布时被定位为对标 Opus 的答案,如今在网络安全上以明显差距居首,而 Gemini 4 Carbon 本是专为网络防御者推出,这一反超出乎意料。
各行业表现分化
最值得注意的数字不在榜首。量化交易里,111 次运行有 70 次不如智能体本该超越的基准策略;一道公开题要求对苹果股价序列做缩尾处理,没有任何模型解出。Fleet 设计的对齐测试结果更沉重:200 次运行中 196 次违反至少一条行为规则,173 次触犯被归为严重失准的规则。医疗任务上,100 次运行只有 19 次得分高于零。
安全过滤器的行为在基准之外同样难以预料。一段带有假生物武器函数的反爬虫脚本拦住了 Astra,GLM-5.3 却照常运行;Opus 5.5 也曾开始拒绝完全合法的二进制分析。发布方写明,Opus 5.5 和 GPT-6 Astra 的安全分类器让模型拒绝了网络安全、生物和对齐方面的任务,因此 12.0% 同时衡量了模型能力与守门机制放行的尺度。
金融和法律的分数并非真实水平。按预设的二元评分,所有模型在这两个行业都是零分,SemiAnalysis 只好公布部分得分的平均值,规则不同,这些数字无法与其他领域直接比较。
与 GDPval 的区别
GDPx 的靶子很明确:OpenAI 于 2025 年 9 月 25 日发布的 GDPval,也是各家模型发布材料里引用最多的标尺。GDPx 作者的指责落在任务形态上,GDPval 的每道题都在请求文本里写全,没有交互,模型等于被人把所需背景喂到嘴边;作者还提到,参考子集上人类评审者的一致率只有 71%,对一把量尺来说不算高。
GDPx 的每个任务则自带一个需要探索的环境。24 道金融题还原了一桩真实的私募股权交易:基金以 8.8 亿美元加业绩对赌,收购一家零食厂商约 62% 的股份,材料约 4,000 份匿名文件,数字要由智能体自己从中挖出来。发布方称,这就是课堂作业和在办公室干一周的差别。
质量控制方面,SemiAnalysis 称要求每家合作方的任务首次就通过自动校验,至多容许细微错误;同一套流程若用在 Terminal Bench 4.0 上,近半数任务会被判为有缺陷。
局限与使用建议
需要指出的局限包括:打分的人正是卖基准测试的人。SemiAnalysis 与十四家合作企业共同设计任务,还向数据公司开放了参与后续版本的入口,榜单诞生于商业产品内部,外部实验室尚未复现。公开的任务也很少,只有一部分可见,基准测试大部分不公开,读者无从核实难度,只能信任出题的人。
对评估智能体的企业来说,12% 不等于这些工具没用,它说明的是从头到尾的完整专业工作眼下还不能整个交出去。真正好用的仍是中间环节,比如在档案库里检索、起草初稿、交叉核对,由人把控全程并为结果负责。成本栏同样实用:Gemini 4 Carbon 比 Opus 少一个百分点,花费只有三分之一,在每天跑上千次的流程里,这笔账是算术,不是立场。
发布方预告后续版本每三到六个月推出一次。届时才能知道 12% 会不会迅速上涨,还是像 GDPval 评审者那 71% 的一致率一样原地不动。
要点
- GDPx 于 2026 年 11 月 2 日由 SemiAnalysis 发布
- 共 206 项任务,覆盖十一个行业
- Claude Opus 5.5 以 12.0% 排名第一
- Gemini 4 Carbon 得分 10.9%,GPT-6 Astra 为 9.6%
- 参测十三个模型均未达到总量的五分之一
正在读取登录状态…
暂无讨论,说说你的看法吧