 Mores
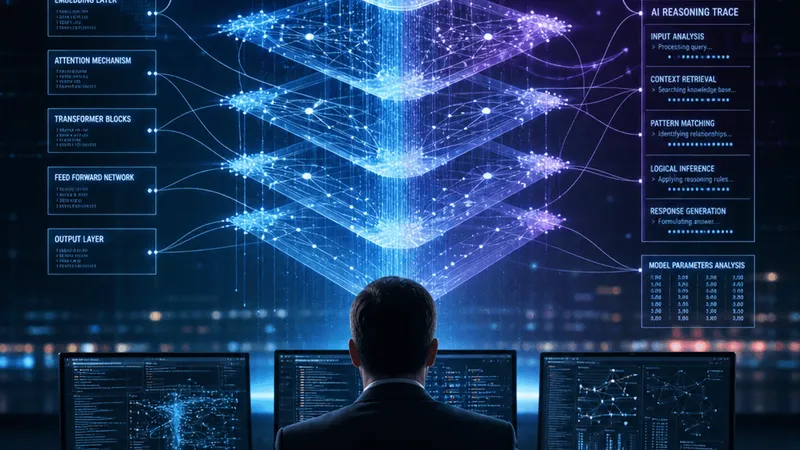
一项AI可解释性研究取得进展:研究人员开发出一种技术,可从Anthropic的Claude、OpenAI的GPT系列和谷歌的Gemini等主流大模型中提取隐藏的“推理轨迹”,即模型在给出回答前逐步展开的内部逻辑。相关发现由Wired报道。
研究团队随后将该方法用于若干中国AI模型,发现其推理模式与美国领先模型存在高度相似之处,提示这些系统可能曾以美国模型的输出作为训练数据。谷歌拒绝就具体发现置评,Anthropic确认知晓该研究但强调提取推理轨迹不会危及模型安全或用户隐私,OpenAI则援引其禁止用API输出训练竞品模型的现有使用政策。
提取方法是什么
该技术针对的是模型在给出最终回答之前逐步展开的内部逻辑,研究团队将其称为“推理轨迹”。与此前只能观察输入和输出的方法不同,这一路径试图呈现中间的计算步骤,相当于在模型交出最终答案前读到它的草稿。
据来源描述,提取并不依赖模型被明确要求解释自己,而是从底层神经网络的激活中获取推理轨迹。早期迹象显示,方法涉及分析模型推理过程中的注意力模式与中间层激活,即观察模型处理查询时哪些神经元以何种顺序被激活。
研究团队尚未完整披露技术细节,计划在正式论文中发表。来源同时提到,这一进展被视为AI可解释性领域的一次跃升,该领域长期难以说明大语言模型究竟如何作出决定。
中国模型的相似模式
研究人员随后把提取方法用于若干中国AI模型,发现这些模型与美国领先模型之间存在高度相似的推理模式。来源称,相似之处不只是答案接近,而是推理结构近乎一致,这种重合被解读为一方可能直接学习了另一方的输出,而非仅从原始训练数据中学习。
来源用一个比喻描述这种情形:两名学生不仅得出相同答案,连解题过程也一模一样,包括同样不常见的捷径。不过来源也明确表示,关于是否存在有意的模型克隆,目前仍缺乏确凿证据。
这一发现出现在中国多家AI公司相继发布能力接近美国模型的背景之下,而这些公司因出口限制只能获得相对不先进的硬件。美国政策制定者此前曾质疑这种快速进展如何实现,来源认为这项研究可能提供了部分答案。
三家公司的回应
OpenAI则援引其现有使用政策,该政策禁止使用API输出训练竞争性模型。
来源指出,当训练发生在海外时,这类政策的执行仍面临挑战。三家公司的表态均未涉及研究的具体结论,也未确认或否认中国模型与其输出之间的关系。
对出口管制的启示
美国政府对先进AI芯片的出口管制逐步收紧,其担忧在于中国在该领域的快速进展。但来源提出,如果企业能够通过公开API获取的输出有效复制美国模型,仅靠硬件限制不足以维持美国在AI领域的领先地位。
在这一视角下,模型本身已成为技术转移的载体。来源预计,这项研究可能出现在国会听证会和贸易政策讨论中,并认为维持领先需要同时依靠硬件限制与模型安全,而不只是其中一项。
透明与复制的两难
对AI安全研究者而言,能够看到模型如何推理,有助于识别幻觉、有缺陷的逻辑以及从训练数据中习得的非预期模式。来源称,已有多家AI安全机构联系合作,希望将该技术用于对齐研究。
但同样的透明度也服务于竞争情报:若能大规模提取推理轨迹,就可能勾勒出模型的强项、弱项与训练偏差,形成复制的蓝图。Anthropic与OpenAI都曾倡导AI开发透明,这一发现可能迫使它们重新权衡通过公开API暴露多少内部推理。
来源将这项研究视为AI可解释性与国际AI竞争的双重转折点:它既让研究者得以窥见黑箱内部,也暴露出模型输出本身可能在向竞争对手泄露有价值的训练信号。
要点
- 方法可提取Claude、GPT、Gemini的推理轨迹
- 部分中国模型与美国模型推理结构高度相似
- 谷歌拒绝就具体发现置评
- OpenAI称其政策禁止用API输出训练竞品
- 技术细节尚未完整公开,研究者计划正式发表
正在读取登录状态…
暂无讨论,说说你的看法吧