 Mores
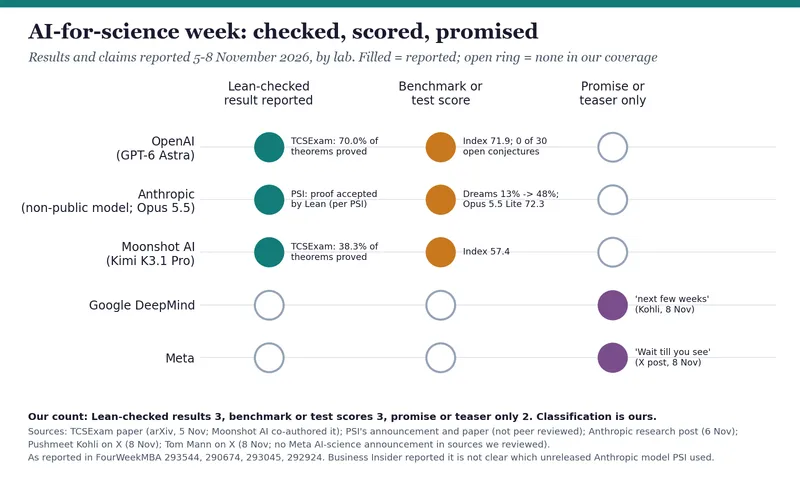
据对11月5日至8日公开报道的梳理,OpenAI、Anthropic和Moonshot AI三家实验室的模型先后有经Lean证明助手检验的结果公布;同期谷歌DeepMind与一名Meta员工只给出预告或暗示,未公布可核验的成果。
其中OpenAI的GPT-6 Astra在一项名为TCSExam的基准测试中,对20个研究定理中的70.0%给出了完整的机器检验证明,但未能解决该基准中的30个开放猜想。
三家的机器检验结果
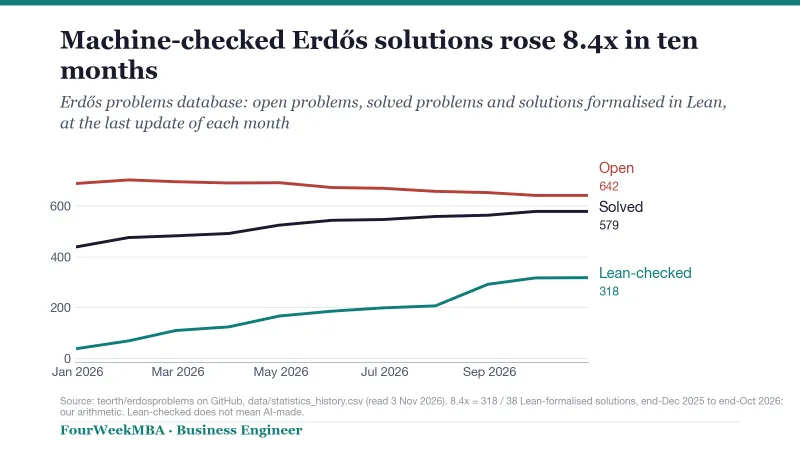
Lean是一种交互式定理证明工具,其内核会对提交的形式化证明给出通过或拒绝的判定,因此这类结果被归为机器检验证据。
上述分组与计数来自报道方自身的梳理,报道方也说明,换一种分组方式会得到不同的计数。
报道方将本周的证据分为三类:经Lean检验的结果、基准或测试得分、以及承诺或预告。按这一口径,三家实验室共有三项经Lean检验的结果,三项基准或测试得分,另有两条预告或暗示。
TCSExam基准与得分
TCSExam是一篇于11月5日发布到arXiv的基准论文,其定理赛道要求提交的证明能被Lean内核接受。论文作者来自清华大学、Moonshot AI与上海期智研究院,而Moonshot AI本身也是被评测模型的开发方之一。
Moonshot的Kimi K3.1 Pro以38.3%位列第二,其余六个在完整套件上测试的智能体最高只达到11.7%。
在论文的TCSExam综合指数上,GPT-6 Astra得71.9分,Kimi K3.1 Pro得57.4分。Anthropic的Opus 5.5只运行了20项任务的Lite套件,以72.3分在该套件上领先。
报道方对论文的解读是,70.0%的定理证明率与30个开放猜想全部未解之间的落差,区分了证明一个已陈述的结果与解决一个开放问题这两件事。
PSI的猜想证明声明
物理超级智能(PSI)于11月6日发布声明,称其系统在运行的第三天得到了Aaronson–Ambainis猜想的完整证明,并称Lean接受了该证明。该声明称这一问题自2008年起一直开放。
PSI表示,这次运行使用了非公开Anthropic模型的实例。据Business Insider在11月7日的报道,目前尚不清楚PSI具体使用了哪一个未发布的模型,Anthropic也未回应置评请求。
该论文尚未在同行评审期刊上发表,报道方也未找到Scott Aaronson或Andris Ambainis对该结果的公开评价。因此这一结果按PSI自己的说法属于机器检验,但未经同行评审,所用模型也不公开。
DeepMind与Meta的预告
谷歌DeepMind的Pushmeet Kohli于11月8日在X上发文,称团队在多个项目中正目睹科学发现速度出现真正的相变,并表示读者将在未来几周的发布中看到其中一瞥。该帖没有点名任何产品或日期。
同日,Tom Mann在X上发帖并引用Kohli的话,写道等着看他们在Meta做了什么。报道方指出,在其查阅的来源中,Meta没有发布任何AI-for-science方面的公告,也没有确认发帖者在Meta的具体职务。
作为对照,谷歌此前的ScientistTwo论文是另一类证据。该论文由谷歌云AI研究、谷歌与滑铁卢大学的作者于9月17日提交,报告称在自动AI评审代理下,其平均评审评分高于人类撰写的论文,但评审者是自动代理而非人类评审。
此外,OpenAI联合创始人兼总裁Greg Brockman于11月8日发文称,带有大量测试时计算的前沿模型正成为科学发现的引擎。报道方注明,这属于Brockman本人的表述。
证据类型与未确定之处
报道方强调,Lean检验通过只说明一个形式化陈述得到了证明,本身并不说明该形式化陈述与数学家所陈述的问题相符。这是解读此类结果时需要区分的一层。
在Anthropic方面,其研究帖称让Claude“做梦”,即离线回顾过往会话日志并重写自身记忆,使一项25题测试的达标标准比例从13%提升到48%,按报道方计算为3.7倍。该结果是Anthropic自己的测试,并非独立检验。
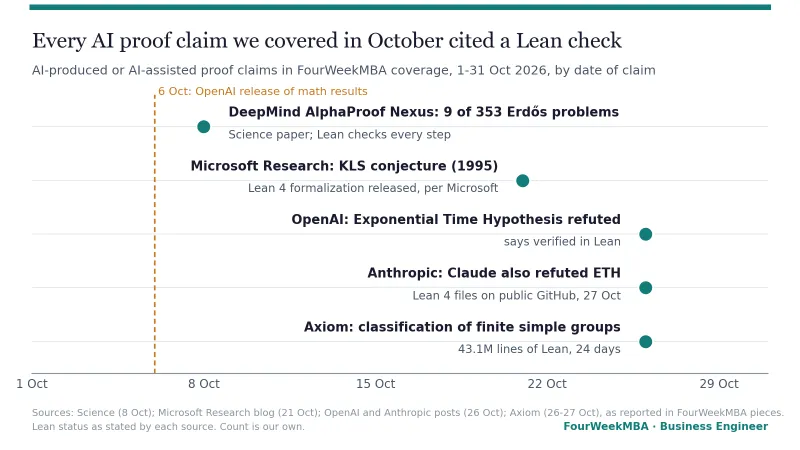
更早的背景是,OpenAI于10月6日发布了由内部模型生成的722篇稿件,其仓库的历史文件后来把已形式化的顶线结果占比记为300/719,即42%。
报道方还列出若干未确定之处:PSI的论文未经同行评审且模型不公开;Moonshot AI是TCSExam论文的共同作者,同时开发了被排名的模型之一;Kohli的帖子未点名任何发布;Tom Mann的帖子未点名产品。
要点
- GPT-6 Astra在TCSExam中证明70.0%的定理
- Kimi K3.1 Pro以38.3%位列第二
- GPT-6 Astra未解决30个开放猜想中的任何一个
- PSI称其证明已被Lean接受,论文未经同行评审
- DeepMind的Kohli称未来几周将有相关发布
正在读取登录状态…
暂无讨论,说说你的看法吧