 Mores
一个名为Unemployment Labs的独立研究团队通过分析公开发布的AI模型权重,发现DeepSeek、月之暗面、MiniMax和蚂蚁集团的部分新模型保留了与英伟达Blackwell GPU架构相匹配的数字特征。研究人员Will DePue于11月12日发布技术调查报告,称这为此前有关中国AI企业获得受美国出口管制限制的Blackwell芯片的猜测提供了新的技术证据。
研究涉及的六款模型分别指向B200、B300或GB200、GB300等Blackwell系列配置。研究人员同时强调,芯片指纹只能反映模型初始化时使用的硬件布局,无法证明后续训练在同一批GPU上完成,也不能直接证明存在违反出口管制的行为。
从模型权重找线索
Unemployment Labs 的研究路径与以往依赖数据中心内部消息、芯片采购记录或供应链文件的推断方式不同,团队直接以公开发布的模型权重为分析对象。模型由数十亿乃至数千亿个可调整的数字参数构成,这些参数即模型权重,在正式训练前需要先获得一组初始数值。
研究团队认为,这组初始数值并非完全随机,其生成与分配方式同 GPU 硬件架构存在关联,因此可以从权重中反向寻找硬件线索。
报告称,这四家企业的六款新模型均出现与英伟达 Blackwell 架构相匹配的数字特征,而它们此前发布的模型主要呈现上一代 Hopper 架构的特征。
硬件指纹如何形成
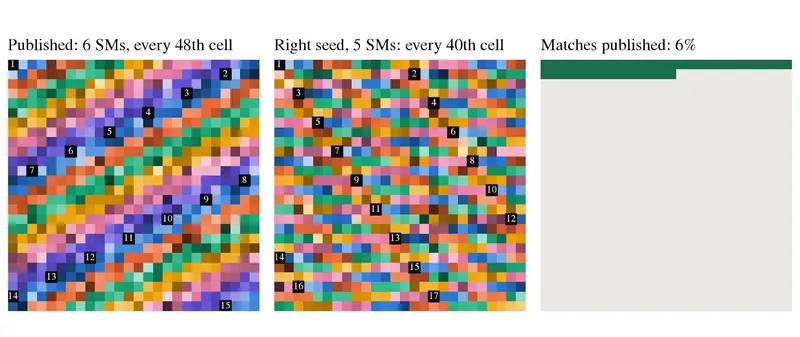
研究指出,PyTorch 框架使用 Philox 伪随机数生成算法初始化模型权重,并通过英伟达 cuRAND 库把计算任务分配给 GPU 内部大量并行线程。不同型号 GPU 的流式多处理器(SM)数量不同,线程布局也随之不同,因此同一个随机种子在不同架构上运行,生成的数字会被分配到不同的权重位置。
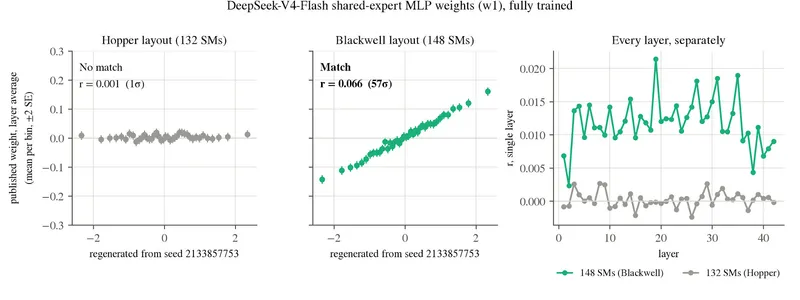
这种差异构成了隐藏在模型中的硬件指纹。正常情况下,初始权重会随训练不断被调整,原始排列特征可能逐渐消失,但研究人员发现部分权重在训练中几乎没有变化,例如用于表示训练数据未涉及的罕见词语或符号的参数,可能保留最初数值;即使权重已经改变,初始值与最终值之间仍可能留有微弱的统计相关性。
团队利用这些残留特征反向寻找最初使用的随机种子和 GPU 线程布局,再与公开权重比对。为排除偶然匹配,研究人员保留部分权重作为独立验证样本,在确定随机种子和硬件配置后,用未参与搜索的数据进行交叉验证。
六款模型的匹配结果
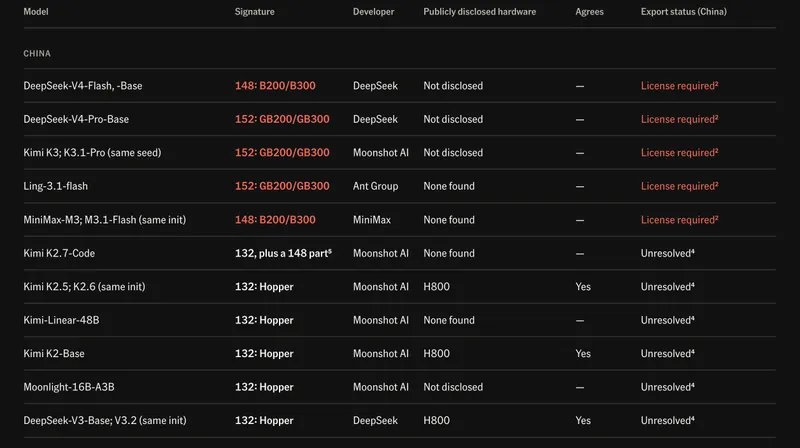
报告给出的硬件对应关系为:DeepSeek V4-Flash 匹配 B200 或 B300,DeepSeek V4-Pro 匹配 GB200 或 GB300,月之暗面 Kimi K3 与 Kimi K3.1-Pro 均匹配 GB200 或 GB300,MiniMax M3 匹配 B200 或 B300,蚂蚁集团 Ling-3.1-flash 匹配 GB200 或 GB300。其中 DeepSeek V4-Flash 和 MiniMax M3 对应 148 个 SM 的 Blackwell 布局,其余四款对应 152 个 SM 的 Grace-Blackwell 布局。
在架构演进上,DeepSeek 于2024年12月发布的 V3 仍呈现 Hopper 特征,2026年4月发布的 V4 系列出现 Blackwell 特征;月之暗面 Kimi K2.5 仍匹配 Hopper,2026年7月发布的 Kimi K3 匹配 GB200 或 GB300;MiniMax 从 M2.7 到 M3、蚂蚁集团从 Ling-3.0-flash 到 Ling-3.1-flash 也出现类似变化。
DePue 还在真实 GPU 上进行了复现:使用一颗 H100 和一颗 B300 运行未经修改的 PyTorch 程序,采用识别出的 DeepSeek 随机种子 953049583,H100 能复现 V3 中保留的初始权重却无法复现 V4-Flash,B300 则相反;B300 测试中 469 组权重行有 461 组相关性超过 0.99,其中 445 组逐位完全匹配。在租用的 GB200 服务器上,团队用随机种子 20256586 复现了 Kimi K3 保留的 13 组初始权重,种子仅改动一个数值后匹配即完全消失。
训练集群规模估算
除判断芯片架构外,研究人员还依据模型规模、激活参数数量和训练 Token 数量估算训练集群。报告认为,六款模型中规模较大的训练任务可能需要数百至数千颗 Blackwell GPU,单次训练持续约两至三个月。
按最佳估计,DeepSeek V4-Pro 需要2000至2500颗 Blackwell GPU,月之暗面 Kimi K3 需要2000至3000颗,DeepSeek V4-Flash 为1000至1500颗,蚂蚁集团 Ling-3.1-flash 约为1100至1650颗,MiniMax M3 约为500至600颗。报告同时给出更宽的单项区间,例如 DeepSeek V4-Flash 可能为250至4500颗,Kimi K3 为1000至8000颗;Wccftech 标题强调的3000至4500颗属于这些区间内的较大规模情景,并非对所有模型得出的统一结论。
成本方面,按每颗 Blackwell GPU 约7万美元计算,最大规模训练集群可能价值1.5亿至2亿美元,六款模型相关训练任务的硬件成本合计超过5亿美元。这些估算仅涉及最终训练阶段,不包括前期实验、模型开发和其他计算资源投入。
结论的边界与争议
研究团队强调,权重中的指纹直接反映的是初始权重生成时使用的硬件配置,不能百分之百证明后续训练在同一批 GPU 上完成,理论上可以在一种硬件上初始化模型再转移到其他设备训练。研究也无法确定这些 Blackwell 芯片实际位于何处,无法判断中国企业是购买芯片、通过第三方数据中心租用算力,还是以其他方式获得访问权限;海外数据中心租赁被视为一种可能解释。
研究人员还指出,经过特殊配置的 AMD 硬件理论上也可能产生某些类似特征,但团队称已排除这一替代解释在 DeepSeek V4-Flash 上的可能性,并认为其他五款模型采用该方案的可能性很低。
从统计角度看,六款模型的最强匹配证据达到49至1385个标准差,远高于团队为排除大规模搜索产生偶然匹配而设定的约8个标准差门槛,最弱的单项测试也达到20个标准差。不过,这仍是一项由独立研究人员发布的技术调查,尚需更多外部团队独立复现;团队已向部分审查者提供复现脚本,完整公开实现细节仍待发布。因此该发现不能直接证明存在违反出口管制的行为,只能支持相关模型初始权重与 Blackwell 特定计算布局高度吻合、开发团队很可能接触过这类硬件的结论。
要点
- 研究分析DeepSeek、月之暗面、MiniMax和蚂蚁集团共六款模型
- 六款模型均出现与Blackwell架构匹配的数字特征
- DeepSeek V3与Kimi K2.5此前仍呈现Hopper架构特征
- 研究推算DeepSeek V4-Pro训练需2000至2500颗Blackwell GPU
- 研究人员称指纹不能证明芯片非法出口或实际所在地
正在读取登录状态…
暂无讨论,说说你的看法吧