 Mores
上海期智研究院、清华大学交叉信息研究院姚期智与袁洋团队,联合月之暗面创始人杨植麟等人发表论文《TCSExam:在TCS研究的全范围内评估前沿大型语言模型》,用100道专家审核的任务检验9个前沿大模型在理论计算机科学完整研究链条上的能力。所有判分由Lean证明器和可执行检查器给出。
结果显示,GPT-6 Astra在bare模式下完成率为70%,Kimi K3.1 Pro以38.3%排第二,其余六个模型最高不超过11.7%。在构造赛道,部分模型给出的数学构造超过了人类公开参考基线;但30道公开猜想中,没有任何模型在评测的12小时内独立完整证明或证伪。
考卷如何设计
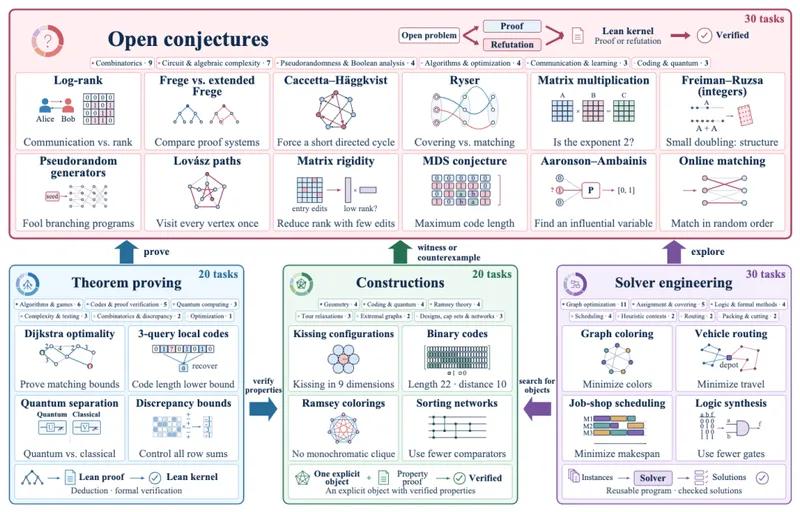
TCSExam完整版包含100道经专家审核的任务,按理论计算机科学研究的日常分工划分为四条赛道:定理证明、求解器工程、构造、开放猜想。研究团队指出,此前的AI评测基准通常只覆盖其中一块,没有人把四块放在一起考过,因此难以判断模型能否像一名真正的TCS研究者那样走完完整的研究周期。
在判分方式上,所有结果都由Lean证明器和可执行检查器给出,而非依赖人工评分或模型自评。论文将Lean 4视为一种让AI结论承担可检查理由的方式,而不只是判分工具。
这一基准与团队同期开展的代数世界模型(AWM)研究共享同一条思路:从探索中发现规律,把规律凝炼为结构,再借助数学理解结构。TCS研究者的工作被概括为证明定理、写求解器搜索实例、构造满足特定性质的数学对象,以及面对长期未解的公开猜想。
模型成绩对比
参与评测的共有9个前沿大模型。GPT-6 Astra在bare模式下完成率为70%,按20道研究级定理计算,它完整证明了其中14道。
提示方式对成绩影响明显。Kimi K3在bare模式下解决了3道定理,切换到guided模式后能解决7道。研究团队据此认为,模型其实掌握不少证明片段,问题在于不知道如何把它们串联起来。
各赛道之间的落差同样显著。DeepSeek V4.1 Flash 0910在bare模式下的定理证明为0分,但在构造任务上有产出,甚至超过了人类已知最优结果。
构造能力超人类记录
在构造赛道,模型需要生成具体的数学对象,例如码、图、几何构型,并附带性质证书。GPT-6 Astra在该赛道平均得分104.9,超过了人类公开参考基线。
Kimi K3在测试过程中做出两处改进:一是把124顶点无三角形图的边数从629推到630,二是把量子纠错码[[25,7,6]]的最小距离从5提高到6。研究团队认为,这意味着AI在某些具体数学构造上已经超过人类目前公开的最好结果。
在开放猜想赛道,GPT-6 Astra给出了Alon-Jaeger-Tarsi猜想在F₅域下n≤9的形式化验证特例,拓展了此前已知的范围。论文强调,这类特例和边界结果虽不能直接解决猜想,但本身构成数学贡献。
能力分布的不均匀
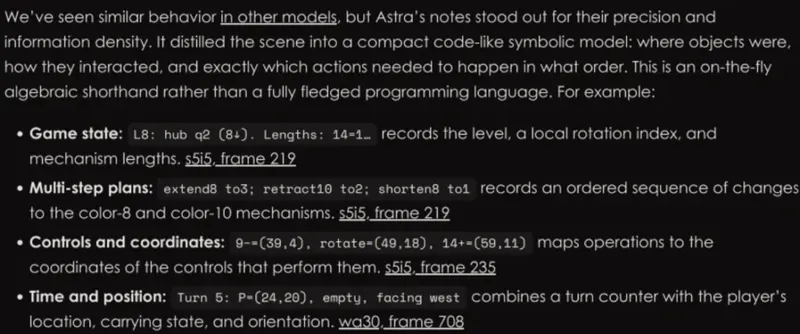
两项研究都注意到模型能力分布极不均匀。同一个模型可能在定理证明上一道都做不出来,却在构造任务上改进人类的公开记录;反之,能给出高信息密度规则的模型,在难度提高后又会给出错误判断。
论文将后一种现象与AWM研究中的观察相对照。在ARC-AGI-3的交互式游戏中,GPT-6 Astra配合Provider Adapter框架可取得99.9%的得分,它会把游戏机制整理成符号化规则,信息密度高于其他模型,但各条规则之间缺少统一结构。
研究团队把游戏关卡改为无解设置后,两个基线模型共12次运行中只有5次判断出“不可能”,其中4次给出的最低成本是错的,唯一算对的一次也承认没有验证路径是否最短。团队将这类错误判断称为模型幻觉,并认为在现实任务中可能带来严重后果。作为对照,基于较弱Opus 5的AWM只需尝试两次即可证明相关关卡无解,并在ARC-AGI-3全部25个游戏、183关中全部通关,通关动作数为人类基线的43%。
开放猜想仍无解
论文提到,有两个模型复用了OpenAI已公开的Ryser猜想和MIRUP猜想反例,完成了两道公开猜想任务,但仍不属于独立证明。
研究团队由此判断,这类公开猜想已落入模型能力可触及的范围,只要配上更严格的信息隔离、限制对已有答案的检索,就能成为更有效的试金石。论文同时指出,在既有框架内改进已知结果、重新拼接已有证明片段,与跳出现有框架提出全新概念和方法,仍是两种不同层次的能力。
两项研究共同提出的价值标准是:即使模型没有完整解决公开猜想,验证某个特例、改进某个上界、跑通某个求解器,也可以是实实在在的科研贡献。团队期待的下一代智能体,不只会报告“我成功了”,还能给出可被机器核验的理由。
要点
- TCSExam含100道专家审核任务,分四条赛道
- GPT-6 Astra在bare模式完成率70%
- Kimi K3.1 Pro以38.3%位列第二
- 30道公开猜想无一被模型独立解决
- 判分由Lean证明器与可执行检查器给出
正在读取登录状态…
暂无讨论,说说你的看法吧