 Mores
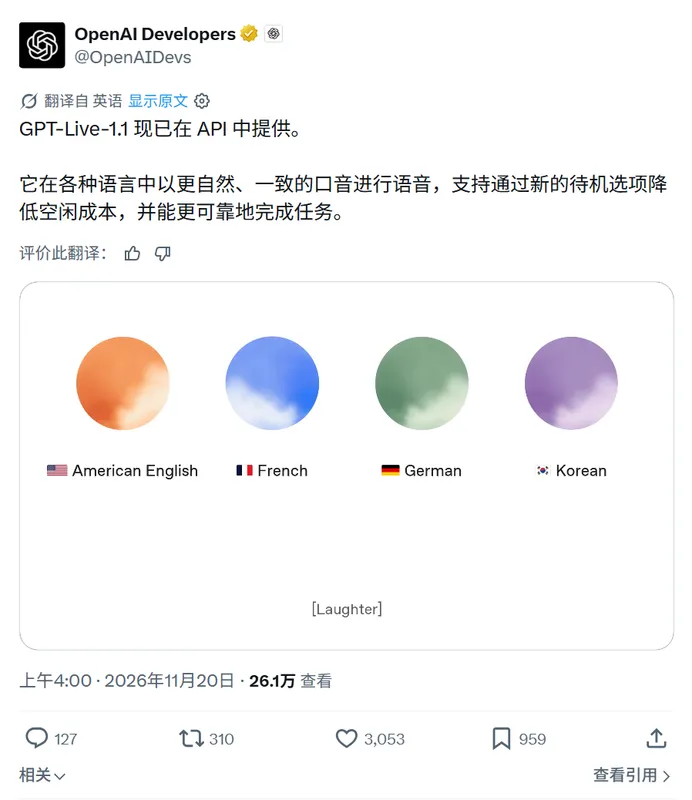
OpenAI于11月20日正式向全球开发者开放GPT-Live-1.1语音模型API,第三方应用可借此构建具备实时聆听、动态响应与复杂任务执行能力的语音智能体。该模型自2026年10月15日起已是ChatGPT Plus及更高阶订阅用户的默认语音引擎,此次开放意味着其核心能力面向生态开发者释放。
全双工交互如何工作
GPT-Live-1.1采用全双工语音交互架构,语音输入与语音输出可以同步进行。模型不必等用户把话说完,就能启动理解并生成回应,这与传统一问一答式的语音交互存在明显区别。
在对话过程中,模型会捕捉语句中的停顿、中途打断以及语速变化,并据此判断当下应当继续倾听还是即时回应。OpenAI方面将这一能力描述为提升对话流畅度与拟人性的关键。
该模型是GPT-Live-1的增强版本,其定位是让第三方应用构建能够实时聆听、动态响应并执行复杂任务的语音智能体。此次开放后,这些能力从OpenAI自有产品扩展到外部开发者。
任务委托机制
GPT-Live-1.1支持任务委托机制。当请求需要深度推理、调用外部工具或经过较长流程处理时,模型可以把任务转发给开发者指定的后端模型,由后者完成相应工作。
后端模型的选择并不限于OpenAI自有服务。开发者既可以选用OpenAI提供的大模型服务,也可以接入自研或第三方推理引擎,前端语音对话在整个过程中持续进行,交互不中断。
按照OpenAI的说明,这种前后端分工让语音智能体可以边说边想、边听边做。例如用户通过语音提问的同时,后台已经启动数据库查询、日程调度或代码生成等操作,从而提升复杂工作流的自动化程度。
性能与架构优化
在性能层面,GPT-Live-1.1针对多语言语音识别的鲁棒性、指令理解的准确性以及合成语音的保真度做了优化。来源特别提到,模型强化了对字母、数字、代码片段等高精度信息的识别能力,以降低语音交互中的误读与歧义。
架构上,GPT-Live系列依托原生音频端到端处理能力,跳过了传统语音系统中语音识别、大语言模型与语音合成分阶段串联的链路。OpenAI称,这一设计显著压缩了端到端延迟,为实时语音交互提供了底层保障。
此前的订阅端应用
GPT-Live-1.1并非首次对外亮相。自2026年10月15日起,它已经是ChatGPT Plus及更高阶订阅用户使用的默认语音引擎,在订阅产品中积累了一段时间的实际使用。
此次API开放意味着该模型的核心能力从ChatGPT订阅端走向生态开发者。第三方应用由此可以在自有产品中调用同一语音引擎,而不必自行搭建完整的实时语音链路。
开发者接入方式
OpenAI已在开发者平台上线GPT-Live-1.1的完整技术文档、快速接入指南及示例代码。开发者可以据此评估模型能力、完成环境配置并启动集成开发。
从接入路径看,开发者需要同时考虑前端语音交互与后端任务处理两部分:前者由GPT-Live-1.1承担,后者则按需对接OpenAI服务或自研、第三方推理引擎。OpenAI尚未在来源中披露该API的定价与调用限额信息。
要点
- GPT-Live-1.1于11月20日开放API
- 模型采用全双工语音交互架构
- 可捕捉停顿、打断与语速变化
- 支持将任务转交后端模型处理
- 10月15日起已是付费订阅默认语音引擎
正在读取登录状态…
暂无讨论,说说你的看法吧