 Mores
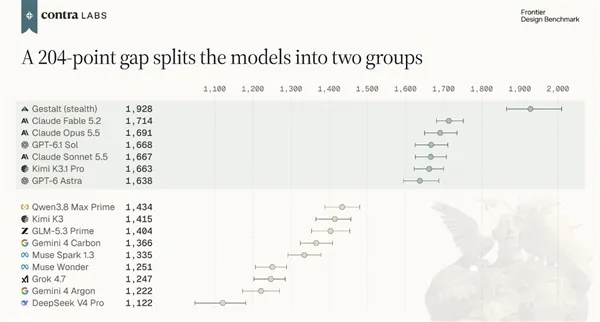
11月19日,Contra Labs推出名为Frontier Design Benchmark的AI榜单,用于测试大模型的商业设计能力。一个以隐身模式在OpenRouter提供调用的神秘模型Gestalt登顶,得分1928分,远超Anthropic旗下Fable 5.2的1715分。
目前尚无足够信息确定Gestalt的所属方,Anthropic、OpenAI、谷歌等头部厂商均已被排除,其真实身份引发行业关注。
榜单与测试方式
Frontier Design Benchmark由Contra Labs于11月19日推出,定位与常见的通用能力或代码能力评测不同,专门用于测试AI大模型的商业设计能力。榜单共设置33个设计任务,模型完成这些任务后,由受邀的专业设计师进行打分,最终形成排名。
在Gestalt出现之前,这一榜单长期由Claude家族的旗舰模型占据榜首,因此它被视为观察头部模型设计能力的一个窗口。Gestalt则以Stealth(隐身)模式在OpenRouter提供调用,在榜单上位列第一。
断层式的分数差距
从分数看,Gestalt拿到1928分,Anthropic旗下Fable 5.2为1715分,两者相差214分。来源将这一差距形容为断层式领先:其他大模型之间领先对手通常只有几十分,拉开20分的差距都不容易。
Fable 5.2被来源描述为全球用户公认最强的模型之一,因此它落后214分这一结果,成为Gestalt引发讨论的直接原因。来源同时提到,Anthropic近期还有Opus 5.5等模型,并称其风头正盛、已把OpenAI甩开一段距离。
Gestalt身份成谜
来源认为,这个问题比它为何这么强更引人关注,因为这意味着在Anthropic、OpenAI、谷歌三家之外,有公司能做出性能更强的大模型;如果这家公司还不是美国的,意义会更大。
来源还提出一种行业层面的看法:AI行业不应垄断在少数几家厂商手中,仍需要初创公司带来有价值的技术突破。Gestalt的真实身份因此成为榜单之外最受关注的悬念。
被排除的候选厂商
来源对几家美国公司逐一作了排除性分析。Meta几乎被确定排除;Anthropic当晚敲钟上市,如果手握这样强力的模型,不太可能用匿名方式宣传;OpenAI近期模型表现被来源形容为拉跨,若有压箱底的产品,早该拿出来洗刷污名,也没必要以这种模式造势。
谷歌同样被认为没有必要多此一举:其近期发布的几款大模型在口碑与能力上都取得双赢。另一家被提及的美国公司Vercl长期从事设计、前端业务,确有相关需求,但来源判断其在自研大模型上不太可能有这么强的能力,从寂寂无名直接跃升到榜首并不现实。
国产模型的可能性
来源把视线转向国产大模型。其判断是,国产模型近期整体低调,几乎没谁敢期待Gestalt出自国内AI公司;目前尚未发布旗舰模型的主要是智谱GLM和DeepSeek V4.1 Pro。
其中DeepSeek V4.1 Pro的时间点对不上,来源认为没这么快。智谱的GLM-5.5传闻下周发布,时间点符合,外界预期值也高,但预期主要集中在代码方面,其设计能力能否碾压Fable 5.2,来源表示没人敢打包票。Gestalt的最终身份仍有待确认。
要点
- 榜单由Contra Labs于11月19日推出
- 榜单共设33个设计任务,由专业设计师打分
- Gestalt得分1928分,Fable 5.2为1715分
- 两者分差达214分,属断层式领先
- Gestalt以隐身模式在OpenRouter提供调用
正在读取登录状态…
暂无讨论,说说你的看法吧