 Mores
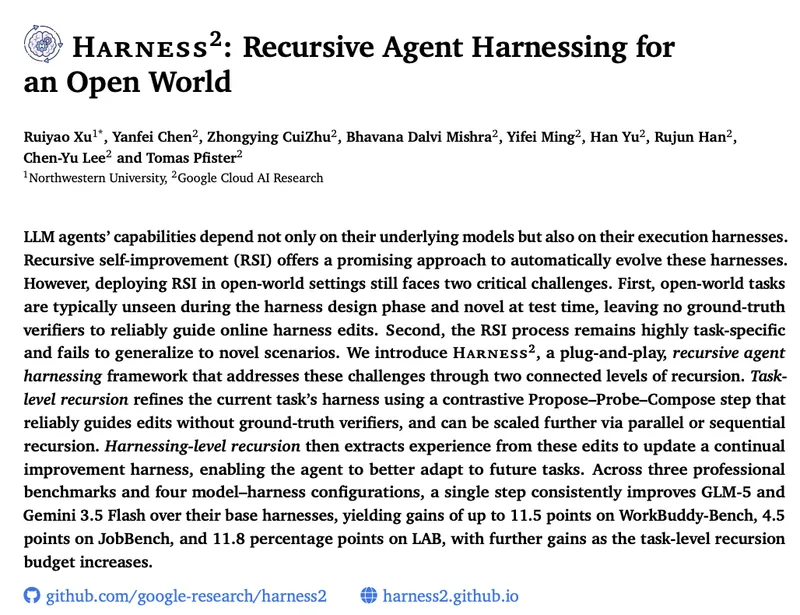
谷歌云AI研究团队联合美国西北大学研究人员开源了名为Harness²的双层递归优化框架,该框架不修改模型权重,而是通过优化智能体外部执行框架来提升任务表现。在锁定模型权重、不依赖真实标签验证的条件下,Gemini 3.5 Flash与GLM-5经过单步优化即在多项专业基准测试中取得提升。
研究团队将这一思路称为递归自我改进(RSI),并已在GitHub开源代码、发布论文与项目主页。框架支持OpenCode与Codex执行器,可直接运行和验证复杂代码逻辑。
不改权重的优化思路
研究团队把这一方向称为递归自我改进(RSI)。其出发点在于,真实业务场景是开放的:没有标准答案,网页每天在变,API随时更新,用户指令千奇百怪,智能体在落地时容易接连出现问题。
传统解法是对模型做微调,但研究团队列出三重障碍:算力与数据标注成本极高;难以从根本上避免灾难性遗忘,教会模型使用新API后可能忘掉旧业务逻辑;许多场景调用的是Gemini、Claude等闭源API,开发者无法触及权重,微调无从谈起。
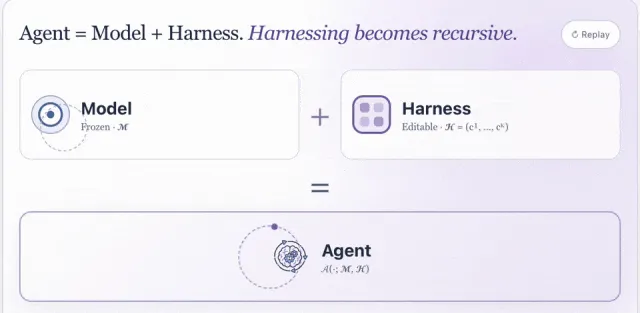
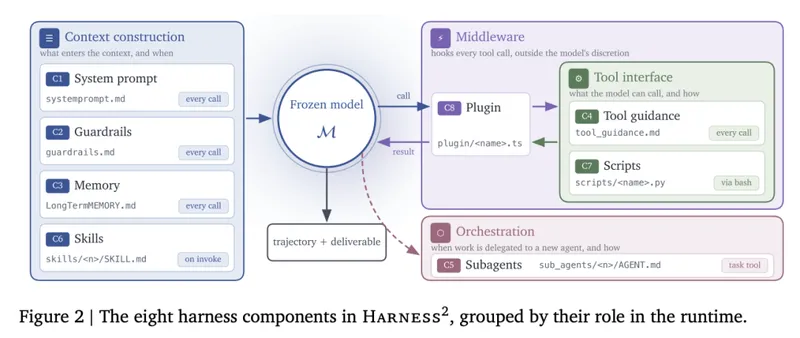
Harness在AI语境中指包围在语言模型外部、帮助模型与现实世界交互的全部基础设施,Harnessing即优化这套系统的过程。Harness²则让优化过程本身递归化:先针对当前任务完善执行框架,再把可复用的框架与经验更新进改进框架,用于指导后续优化。
八大可编辑组件
框架把Harness具象化为八个可编辑组件,被视为智能体的手、眼、记忆和工具箱:系统提示词定义角色与基础规则;护栏设定安全边界、防止危险操作;记忆存储过往经验与上下文;工具指导说明每个工具的具体用法与避坑要点。
其余四个组件分别是子智能体、技能、脚本和插件。子智能体负责把复杂任务拆解并分配给特定的小模型;技能是针对特定场景固化的操作步骤;脚本是自动执行的代码段落;插件则是连接外部服务的接口。
优化的对象正是这八个组件,而非模型参数。按来源的表述,这些组件不仅影响提示词本身,还塑造进入上下文的内容、工具的使用方式、工作的委派方式以及工具循环内部发生的一切,因此改进所能改变的不只是一个提示词。
双层递归架构
第一层是任务级优化,采用被称为PPC(Propose–Probe–Compose,提议-探测-组合)的机制。面对从未见过的棘手任务,框架先分析当前执行轨迹,针对暴露出的痛点提出多个修改八大组件的方案;再让换上不同方案的智能体试跑,通过对比执行差异找出真正解决卡点的提案;最后把表现最好的修改融合起来,形成当前任务的版本。
任务级递归有两种形式:并行递归同时试探多个候选,各自独立组合出下一代框架;顺序递归则在每一步把改进后的框架和积累的执行证据带入下一步。
第二层是元级优化。每次任务级优化成功后,框架会提取其中的核心逻辑沉淀为经验,例如发现处理表格数据时先用脚本清洗空值成功率更高,这些经验附带成功的执行轨迹作为证据。面对全新任务时,元级优化用这些积累的方案与教训指导当前的Harness编辑,使在任务A中学到的工具修改技巧被提炼为通用法则,用于任务B。
基准测试成绩
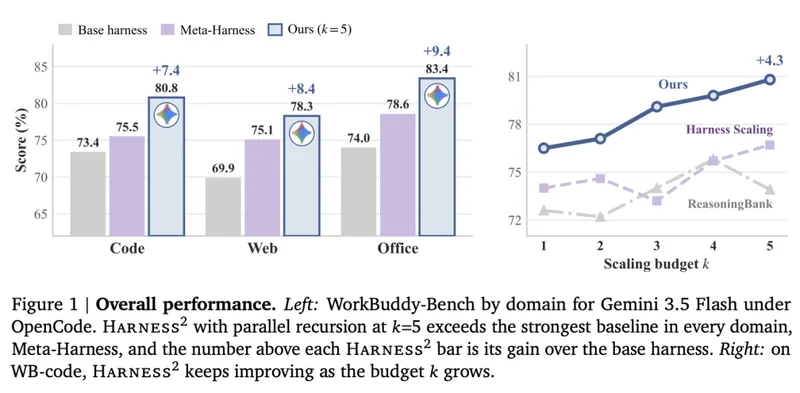
评测在全部锁定模型权重、完全不依赖真实标签验证的条件下进行,测试对象为GLM-5与Gemini 3.5 Flash,且仅经过单步Harness优化。
具体数据为:在考验复杂办公流协作的WorkBuddy-Bench上最高提升11.5分;在模拟真实职业任务的JobBench上提升4.5分;在LAB基准测试中准确率提升11.8个百分点。
论文指出,随着递归预算k增加,即允许智能体多进行几轮自我迭代,其表现还能沿曲线进一步攀升。
业界反响与开源信息
Harness²开源后在硅谷AI圈引发讨论。LangChain核心成员Sydney Runkle在X上转发并发表长评,认为该设计与当前前沿的Agent工程理念中Trace(轨迹证据)与Eval(验证改进)高度一致:任务级循环通过分析轨迹提出改进提案,元级循环则持续学习哪些改进模式在验证中真正有效。
她将这一路径视为智能体在生产环境中走向可靠的必经之路,并形容Harness²相当于在LangChain这类框架之上提供一个全自动、自洽的Agent医生,开发者不必逐行查看日志、手动调优提示词。
该工作由谷歌云AI研究团队联合美国西北大学研究人员完成,来自西北大学的Ruiyao Xu在实习期间参与了此项工作。
要点
- Harness²由谷歌云AI研究团队与西北大学研究人员共同完成
- 框架优化对象为智能体八大组件而非模型参数
- WorkBuddy-Bench最高提升11.5分
- LAB基准准确率提升11.8个百分点
- 完整信息已在GitHub与arXiv公开
正在读取登录状态…
暂无讨论,说说你的看法吧