 Mores
智谱于8月14日发布 GLM-5.3。与上一代 GLM-5.2 相比,基座模型没有变化,提升主要来自后训练 Scaling:数十倍的长程任务环境、更丰富多样的环境类型和超长的后训练时间。智谱称,充分的后训练让模型涌现出超出预期的能力。
GLM-5.3 即日起上线智谱官方编程工具 ZCode 与效率工具 AutoClaw,并在多个编码平台开放抢先体验。API 将很快上线,完整模型权重计划在两周内开源,此前需完成必要的安全加固,以限制潜在攻击能力、保留防御价值。
发布与上线安排
GLM-5.3 即日起在智谱官方编程工具 ZCode 与效率工具 AutoClaw 上线,并向 GLM Coding Plan 全量用户开放订阅。同日 13:00,该计划所有用户的额度完成重置,后台用量统计显示使用额度回满。
除官方工具外,GLM-5.3 还在多个编码平台开放抢先体验,包括 TraeWork、TraeCode、扣子、WorkBuddy、CodeBuddy、Qoder、QwenWork、CatPaw、JoyCode 与 OpenCode。智谱表示 API 将很快上线。
在此之前,智谱称需完成必要的安全加固,尽可能限制模型的潜在攻击能力,同时保留其防御价值。
编程与智能体成绩
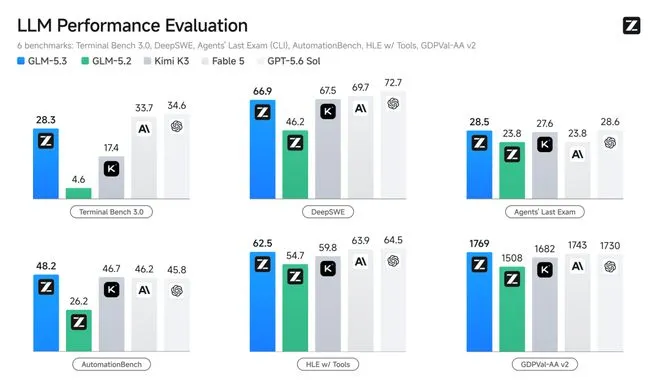
智谱称,GLM-5.3 在多项主流基准测试中是当前排名最高的开源模型,编程与智能体能力接近 Claude Fable 5,编程体感超过其他国产模型。
具体分数上,衡量模型在真实终端环境完成复杂任务的 Terminal-Bench 3.0 中,GLM-5.3 从 GLM-5.2 的 4.6 提升至 28.3;聚焦长程软件工程与持续代码修改的 DeepSWE v1.1 从 46.2 提升至 66.9;覆盖跨工具协作与长程任务的 Agents' Last Exam 从 23.8 提升至 28.5。在覆盖 44 种职业的 GDPval-AA v2 中得分 1769。
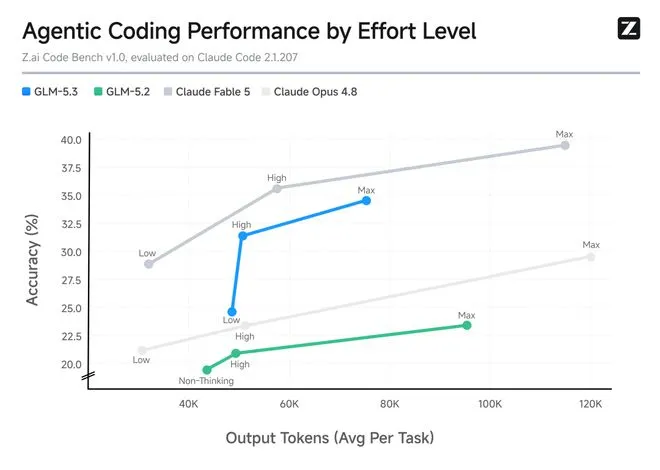
在智谱自研的 Z.ai Code Bench 中,模型被置于复杂本地开发环境执行端到端任务。High 档位下 GLM-5.3 准确率为 31.4%,高于 Claude Opus 4.8 最高档位的 29.5%,且每项任务平均输出约 5 万 tokens,后者约需 12 万 tokens。
训练环境方面,智谱称不只让模型做编程题,而是扩展到接近真实专家工作的完整流程,部分任务工作量相当于一位工程师连续数天的工作,例如使用与算法工程师相同的计算集群、存储系统、内部文档、代码库和实验结果完成机器学习优化任务。
网络安全能力评测
智谱称,安全能力的出现并非偶然,安全工作本质上是约束严格的编程能力。公司从 2025 年 9 月开始在该方向投入研究,并在 GLM-5.2 与 GLM-5.3 研发过程中与国内多家头部安全实验室共同推进长程任务环境,构建更专业化的评测与执行框架。
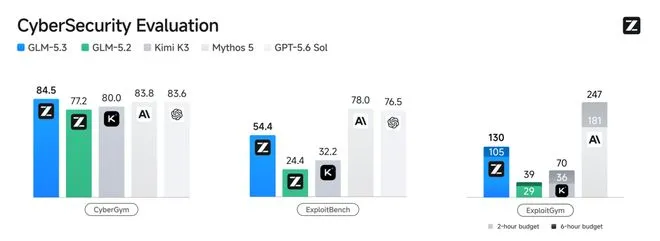
在从白盒源代码出发识别和验证漏洞的 CyberGym 中,GLM-5.3 得分 84.5%,高于 GLM-5.2 的 77.2%,也略高于 Mythos 5 的 83.8% 和 GPT-5.6 Sol 的 83.6%。
在需要理解漏洞成因并完成利用的 ExploitBench 中,GLM-5.3 得分 54.4%,是 GLM-5.2(24.4%)的两倍多,但仍低于 Mythos 5 的 78.0% 和 GPT-5.6 Sol 的 76.5%。
考察限定时间内漏洞利用任务吞吐量的 ExploitGym 中,GLM-5.3 两小时内完成 105 项、六小时内完成 130 项,GLM-5.2 分别为 29 项和 39 项;Mythos 5 在两个时间段分别完成 181 项和 247 项。智谱总结称,越接近漏洞利用链前端,GLM-5.3 相对前代的提升越明显,越深入完整利用,与闭源前沿模型的差距越大。
漏洞发现与联合评估
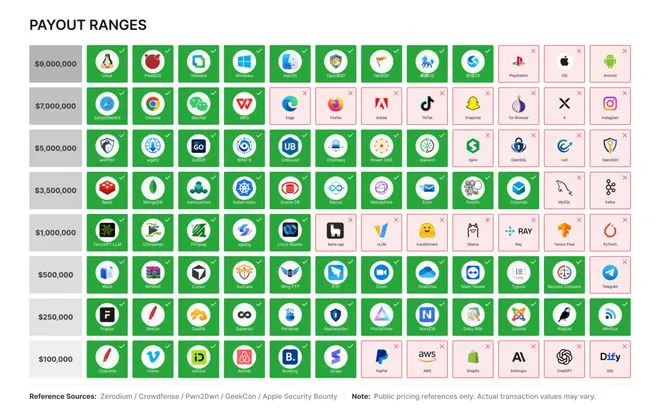
智谱称,自 GLM-5.2 发布以来,公司联合清华大学、南开大学,以及云起无垠、绿盟科技、赛博昆仑、DARKNAVY、华顺信安、奇安信、安恒信息、元序星核、腾讯玄武、云鼎实验室等多家安全团队开展红队测试与安全评估,累计发现漏洞 2436 个(经初筛、去重),其中 1097 个为中高危,最早的可追溯至约 45 年前。
这些漏洞覆盖系统内核、操作系统、浏览器引擎、开源基础组件、互联网应用与互联网协议等 269 个项目,部分漏洞可能让 Android、Windows、macOS 以及某国民级通信软件出现大范围崩溃。相关漏洞已陆续提交 CNNVD、CNVD 等国家漏洞库,智谱还建立了 Z.ai 安全披露账本。参照 Zerodium、Crowdfense、Apple Security Bounty、Pwn2Own 等公开报价,智谱称这些漏洞创造的经济价值达 3000 万元。
来源还列举了若干案例:清华大学 NASP 实验室借助 GLM-5.3 分析 Cursor 的二进制代码、跨语言架构与权限边界,发现 Rust 与 Electron 混合架构及权限校验逻辑中的潜在失陷风险,已联系 Cursor 推进修复并上报 CNVD 和 CNNVD;清华大学 NISL 实验室与云起无垠在 1983 年诞生的 DNS 协议中发现一类潜伏 40 余年的协议级漏洞,攻击者少量特殊请求可将服务器计算压力最高放大近 8 万倍,据网络测绘估算可能影响全球九成以上主流 DNS 系统、涉及超过 1000 万处公网 DNS 服务。
此外,赛博昆仑借助 GLM 模型发现三枚微软重大漏洞,涉及邮件预览、文档处理和服务端远程访问,已提交微软并完成修复,微软官方致谢“Kunlun Lab&GLM”;DARKNAVY·深蓝的 deepsec 借助 GLM 模型在一家具身智能机器人厂商系统中发现漏洞,攻击者一旦利用可能同时远程劫持上千台机器人。上述漏洞均已联系厂商修复,并进入国家漏洞库披露与协同修复流程。
来源还提到一起追踪案例:2026 年 7 月,FOFA 的追踪分析引擎 Ferret 监测到一台位于巴西的临时文件服务器,GLM-5.3 分析发现一个名为“Neo”的 AI Agent,其管理 4 台服务器、7 个域名、6 万个邮箱和 100 多个脚本,发出 18567 封钓鱼邮件,模型辅助研究人员还原了整条攻击链。
开源的盾计划
智谱以 Hugging Face 官方披露的安全事件为警示,认为如果强大的攻击能力正在扩散,防守能力就不能只掌握在少数闭源模型公司手中。来源称,Anthropic 向约 150 家大型机构提供 Mythos 模型及安全服务,更广泛的企业和开源项目难以获得同等水平的安全能力支持。
随 GLM-5.3 发布与开源,智谱同步启动“开源的盾”计划,内容包括:对重点开源项目开展持续安全审计,帮助维护者免费发现和修复风险;向开源社区免费提供模型额度及更便捷的防御入口,开源项目维护者可申请用于安全审计和防御任务;在 ZCode 中提供代码审计功能,让安全检查进入日常研发流程。
在风险审查方面,智谱称针对 GLM-5.3 构建了分层设计的审查系统,横跨外围 API 到模型内部,遵循纵深防御与风险分级原则,让分类器、监控器和模型以意图而非关键词为中心进行判断,并对安全知识问答、蓝队防御、CTF 题目、漏洞挖掘与修复、漏洞利用与攻击、渗透测试、真实入侵等任务分类构造阶梯型风险实例数据。模型最敏感的能力仅通过“网络安全受信访问”计划保留给经过验证的用户。
智谱称,正式开源前邀请国内顶级安全团队对模型风险任务能力进行评估,DARKNAVY 团队认为该模型在风险防护与能力释放之间取得了良好平衡,相比前代显著提高了未授权恶意滥用的门槛。
要点
- GLM-5.3 基座模型未变,提升来自后训练 Scaling
- Terminal-Bench 3.0 得分从 4.6 提升至 28.3
- DeepSWE v1.1 得分从 46.2 提升至 66.9
- 完整模型权重计划两周内开源
- 联合安全团队累计发现漏洞 2436 个,其中 1097 个为中高危
正在读取登录状态…
暂无讨论,说说你的看法吧