 Mores
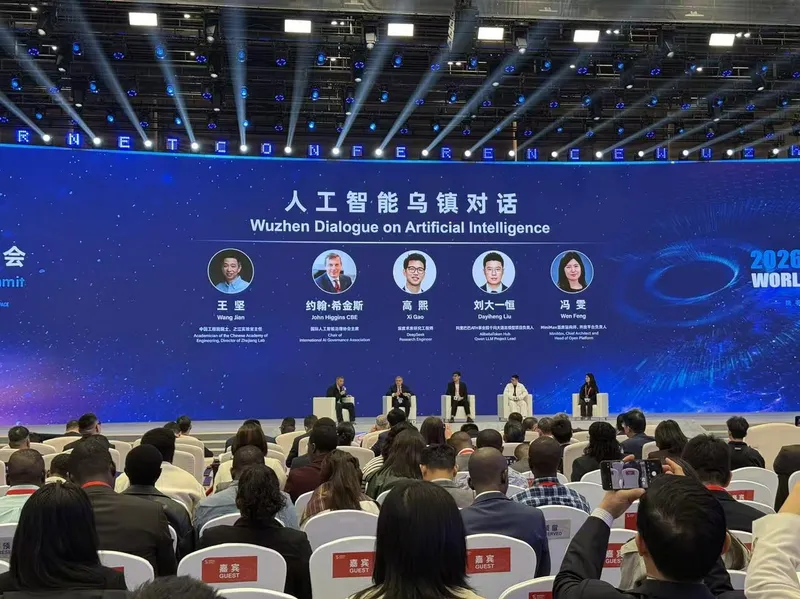
11月3日下午,2026年世界互联网大会乌镇峰会主论坛举行人工智能乌镇对话,全球领军科技企业、开源大模型企业负责人与人工智能科学家同台,讨论开源开放在通用人工智能(AGI)竞赛中的角色,以及如何更负责任地释放技术能力。
深度求索研究工程师高熙、阿里巴巴ATH事业群千问大语言模型项目负责人刘大一恒、MiniMax首席架构师冯雯,以及国际人工智能治理协会主席约翰·希金斯参与对话,围绕开源动因与安全治理两方面展开讨论。
开源为何成为选择
深度求索研究工程师高熙在对话中回顾,2025年1月DeepSeek-R1以低成本、高性能获得业界关注,其开源策略打破了此前传统人工智能的研发模式,让全球开发者通过代码共享参与生态建设。他把开源的动因归结为一个朴素而迫切的愿望:让AGI时代尽快到来。
在高熙看来,技术突破真正的对手是时间而非同行。AI正从简单翻译聊天走向推理解题,再到攻关顶尖技术难题,技术早一步落地,人类就可能提前收获治愈疾病、探索宇宙的红利。因此团队在摸索出新的模型结构、训练方法后,选择尽快开源,交给全球同行验证和迭代,而不是筑起技术壁垒。
千问的开源实践
阿里巴巴ATH事业群千问大语言模型项目负责人刘大一恒从三年多的开源实践中给出另一重注解。3年前,他和团队完成通义千问Qwen-7B初代模型的预训练并对外开源,至今已陆续开源超460款模型,全球总下载量突破40亿次。
他认为开源改变了AI创新的范式,打破了算力与机会的垄断,实现分布式的普惠创新。许多学者、学生有创意却缺少算力做实验,开源小尺寸模型给了他们低成本开展研究的平台,全球科研成果和优化方案又反向回馈模型,形成正向循环。
开源还补上了闭源模型难以覆盖的“最后一公里”。面对小语种、小众垂类行业、特殊硬件等场景,头部闭源企业未必愿意投入资源深耕,这恰是开源社区的长板;同时开源打破了模型服务的价格垄断,让AI技术红利流向更多群体。
开源的安全隐忧
开源把代码交到更多人手里,治理与安全问题随之浮现。国际人工智能治理协会主席约翰·希金斯提到一位银行朋友的顾虑:对使用开源AI非常焦虑,因为不知道它的数据来源、训练过程和潜在隐患。他指出,航空客运、汽修保险等传统行业已在时间积累中形成成熟的安全责任体系,而开源世界是多方共建的众包式开发,责任边界相对模糊,一旦出事很难找到单一主体担责。
刘大一恒坦言,对比闭源模型,开源模型确实存在安全上的隐患。开源模型具备不可撤回性,一旦放出会快速传播,若存在缺陷无法像闭源模型那样随时修复;它也没有外生的护网,安全依赖模型本身的能力,容易被第三方开发者绕过。
他还提到,行业过去常按能力对模型分级管控,但这种思路存在盲区,可能忽略模型的潜力。单纯对模型本身设限很难从根源化解风险,还需要更多法律法规、行业规范和基础设施共同作用。
开源如何反哺安全
开源并非站在安全的对立面。刘大一恒提出,模型白盒开放后,全球安全研究者都可以基于它做对抗测试、漏洞挖掘,相当于动员更多人一起寻找隐患,成熟的开源底座能帮助行业搭建更强的防御能力。
MiniMax首席架构师、开放平台负责人冯雯认为,开源方式正在“缝合”模型安全的缺口。模型进入行业深水区后,很多企业持有自有数据,不少领域还有专属行业数据,大家常选择透明度更高的开源模型作为底座,改造为适配业务的专属模型。
她表示,在这一过程中,全球从业者、监管部门、上下游企业会共同探讨模型在各行业部署的安全方案并协同迭代,开源在可控治理层面带来了新思路。高熙则透露,团队正通过模型分析、能力约束等技术路径探索开源模型的安全管控方案,相关成果会持续对外分享。
治理仍需制度托底
对话中,开源被描述为一场与时间赛跑的选择,也是一条需要堤岸的河流:它承载创新活水,但治理的堤岸必须稳固,活水才能持续浇灌出普惠、可信的人工智能生态。
从嘉宾的讨论看,开源的安全问题难以仅靠模型自身解决。希金斯强调建立完善成熟机制的重要性,刘大一恒则把希望寄托于法律法规、行业规范与基础设施的多重托底。开源社区、企业与监管部门的协同,被视为让技术能力更负责任地释放的现实路径。
要点
- 乌镇峰会主论坛举行人工智能乌镇对话
- 高熙称开源是必然选择,真正对手是时间
- 千问已开源超460款模型,全球下载量破40亿次
- 刘大一恒称开源模型具不可撤回性,安全依赖模型本身
- 冯雯称开源正凝聚更广力量共筑安全网
正在读取登录状态…
暂无讨论,说说你的看法吧