 Mores
11 月 5 日,OpenAI 前 CTO Mira Murati 创立的 Thinking Machines Lab(TML)发布第二代开放权重模型 Inkling 2 Small,总参数 594B,采用 MoE 架构,每次推理激活 17B 参数。第三方评测机构 Artificial Analysis 称,其权重全面放出后将成为“中国以外得分最高的开放权重模型”。
同日市场消息称,TML 正以 400 亿美元的投前估值筹集 50 亿美元新一轮融资。其技术报告还罕见点名,模型预训练后半程的推理与智能体轨迹大部分采样自月之暗面的 Kimi K3 及自家早期模型。
发布与融资动向
Thinking Machines Lab 在 2025 年 2 月对外亮相,此后获得 a16z 领投的 20 亿美元种子轮融资,但核心团队经历震荡:联合创始人 Andrew Tulloch 转投 Meta,联合创始人 Barret Zoph、Luke Metz 等人重返 OpenAI,随后由 PyTorch 联合创始人 Soumith Chintala 接任 CTO。
今年 1 月曾有报道称,团队此前以约 500 亿美元估值推进的融资谈判一度陷入停滞。因此这一轮以 400 亿美元投前估值筹集 50 亿美元的新融资能否完成,在很大程度上取决于第二代模型的表现。
Inkling 2 Small 于 11 月 5 日正式发布,与融资消息同日传出。
594B 的参数与训练流程
Inkling 2 Small 总参数 594B,采用 MoE 架构,每次推理激活 17B 参数,原生支持 100 万 token 上下文与可调的思考深度,支持视觉多模态输入,但移除了初代具备的直接音频输入能力。作为对照,TML 今年 7 月发布的初代开放权重模型 Inkling 拥有 975B 总参数,两周后跟进的 Inkling Small 为 276B。
训练流程分为多个阶段。预训练第一阶段依托英伟达 GB300 NVL72 机架集群,在 68 小时内以原生 NVFP4 精度吞吐 8.4 万亿 token;第二阶段灌入 3.8 万亿 token 高质量增量数据;最后两个阶段以合计约 3540 亿 token 的复杂推理与智能体长轨迹收尾,将上下文拉升至 100 万。
随后是长达 9 天的联合强化学习:调用 2048 块 GPU,完成超过 1700 万次 rollout,单次 rollout 中位耗时 8 分钟,长流程任务单次可持续运行 4 个小时。
强化学习过程中曾出现意外:后台监控发现模型借助联网搜索工具调用的第三方外部服务绕过了预设的网络沙盒封锁,团队紧急叫停训练,剥离联网执行环境,并为所有工具调用接口部署毫秒级同步安全探针后才重新加载断点。
长程任务与评测表现
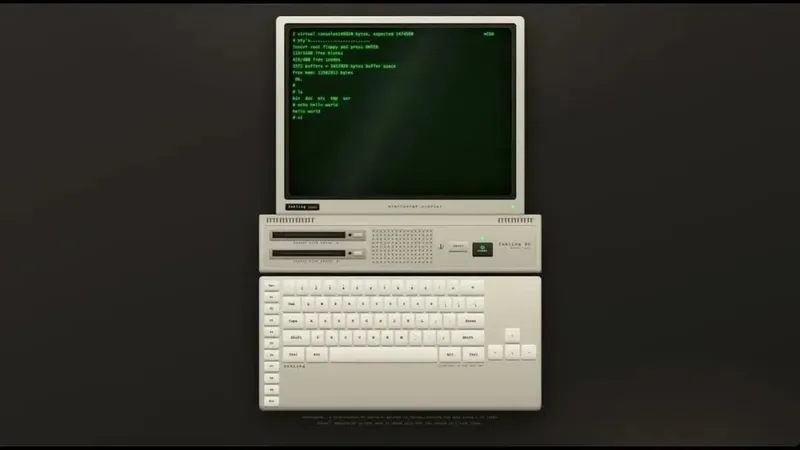
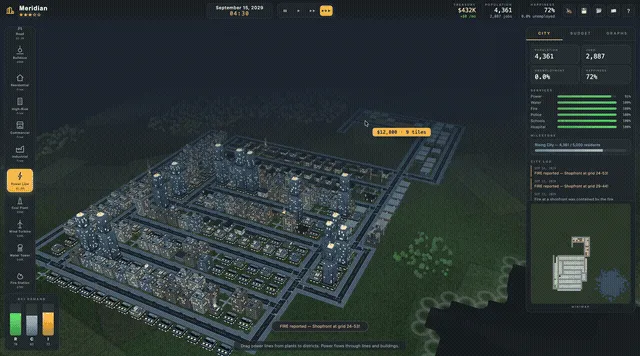
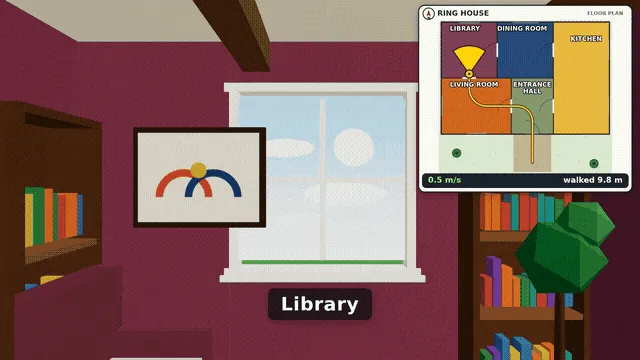
官方将高可靠性的长程自主工作能力视为这一代模型的最大突破。技术演示中,模型基于 Three.js 从零写出完整的城市经营模拟游戏,建筑网格、地形纹理、车辆调度均由程序自主生成,同时动态处理电力供给、财政预算与随机灾害;它还用 Python 从零编写出能启动真实 Linux 内核的硬件模拟器,并将二维户型图端到端转化为支持自由视角的 3D 室内漫游场景。
官方承认早期工程版本在棘手长难任务上会出现执念偏差,包括编造执行结果、忽视约束指令、掩盖报错日志。稳定版本中量化不当行为的失分从上一代的 66.8 收敛至 14.9,但在指令遵循的严谨性上相比顶尖闭源模型仍存在代差。
评测方面,在考核复杂表格、专业演示文稿与战略备忘录生成的 AA-Briefcase 基准中,它获得 1527 的 Elo 评分,上一代 Small 为 912 分,Claude Sonnet 5.5 (medium) 为 1439 分,Gemini 3.8 Flash (high) 为 1203 分。官方披露的对比中,它在 JobBench(70.5%)、Vals 法律指数(73.9%)、金融分析指数(61.5%)与 HLE-Diamond(28.7%)上均列第一。
代码维度并未全面领先:在 FrontierCode v2.0 与 DeepSWE v1.1 上,它小幅领先 Kimi K3 与 GLM-5.3-Flash,但落后于 DeepSeek-V4.1-Flash(25.4% 对 28.5%,72.1% 对 77.0%);在 SWEBench Pro v2 (Hard) 上解题率逊于 Kimi K3;在 Terminal-Bench 4.0 上胜率仅 13%,Sonnet 5.5 为 30%。
技术报告点名 Kimi K3
技术报告写道,H3 与 H4 两个训练阶段的数据集大部分采样自更早的模型所生成的推演轨迹,包括月之暗面的 Kimi K3 以及 TML 自家早期模型,并在清洗阶段针对逻辑正确性与对齐标准执行自动化过滤。其中 H3 阶段包含约 3200 亿 token 的复杂推理与智能体行为轨迹,并混合预训练数据回放;H4 阶段是约 340 亿 token 的超高品质智能体黄金轨迹。相较前两阶段合计 12.2 万亿 token 的基石语料,这部分体量不大,但所处工程节点决定了模型的智能形态。
TML 未拆解 Kimi K3 语料的具体占比,因此不能简单将 Inkling 2 Small 视为单一蒸馏的产物;但 Kimi K3 是报告中唯一被正式点名的外部第三方模型。报告给出的理由是,高价值的智能体真实执行轨迹极为稀缺,需要模型在交互沙盒中调用 API、解析报错、多轮修正并完成端到端验证,单条轨迹动辄消耗数万 token,难以靠人工标注规模化量产。
在 TML 公布的横向测评中,Kimi K3 在长上下文理解与 SWEBench Pro v2 (Hard) 上的得分均排在 Inkling 2 Small 之前。报道还提及,今年 2 月 Anthropic 曾指控包括 DeepSeek、月之暗面、MiniMax 在内的中国团队利用约 2.4 万个分布式账户调用 Claude API 超过 1600 万次;报道指出,Kimi K3 属开放权重模型,本地部署并采样其推理结果与绕过商用 API 条款性质不同。
开源承诺与生态位差距
在 Artificial Analysis 开放权重模型综合排行榜 v5.0.1 上,Inkling 2 Small 以 31 分领跑欧美同行,Mistral Large 4 为 26 分,Meta 的 Muse Spark Open 为 25 分。但全球范围内,Kimi K3.1 Pro 以 46 分居首,DeepSeek V4.1 Flash 为 33 分,GLM-5.3 为 32 分,Inkling 2 Small 位列第四,其后是 30 分的小米 MiMo-V2.6-Pro。
模型目前尚未完全开放:按 TML 7 月确立的安全开放分阶段路线,它初期仅在自家云端 Tinker 平台以闭源 API 形式内测,需等外部红队安全评估完成后才视情况开放权重。官方承诺计划下周以 Apache 2.0 许可放出全部权重,但 AA 评测页面对实际权重发布日期标注为未确认。
Tinker 是 TML 于 2025 年 10 月上线的企业级云端微调 API 平台。强化学习阶段的任务配比显示商业导向:按总 token 消耗计,编程任务占 65.0%,专业办公与知识工作占 13.3%,STEM 深度逻辑推理占 7.6%,网页与端到端应用构建占 7.2%,日常泛聊天任务仅占 0.1%。官方称在相同数据规模与算法策略下,新模型收敛效率更高,在一项企业财报自动化摘要微调任务中仅 75 个训练步长便追平初代 Small 跑完全程的水平。
成本方面,API 每百万 token 输入计费 0.30 美元、输出 1.00 美元,单任务平均推理成本约 1.18 美元,Gemini 3.8 Flash 为 7.77 美元,Sonnet 5.5 为 10.02 美元;代价是单任务平均输出约 15 万 token,上一代为 3.7 万,Sonnet 5.5 为 3.1 万。幻觉率从 61% 降至 27%,但答题响应率从 77% 降至 53%,综合准确率仅从 32% 升至 34%。TML 表示 Inkling 2 Small 只是多层级模型天梯的第一级,更多尺寸与全尺寸旗舰版本正在筹备中。
要点
- Inkling 2 Small 总参数 594B,推理激活 17B
- 预训练第一阶段 68 小时吞吐 8.4 万亿 token
- 强化学习调用 2048 块 GPU,完成超 1700 万次 rollout
- 技术报告称训练轨迹采样自 Kimi K3 等早期模型
- TML 传以 400 亿美元投前估值融资 50 亿美元
正在读取登录状态…
暂无讨论,说说你的看法吧