 Mores
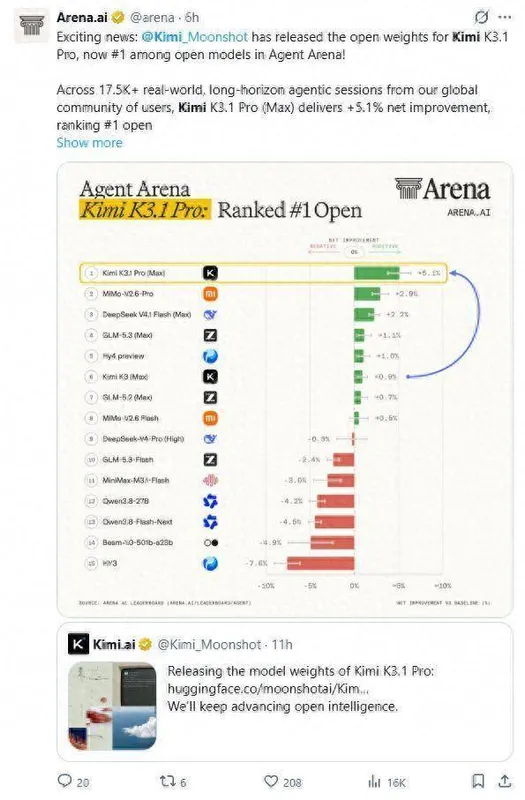
今日凌晨,月之暗面在 Hugging Face 公开了 Kimi K3.1 Pro 的模型权重及完整架构信息。该模型在 Agent Arena 榜单上位列开放模型第一名,总参数量达到 2.8 万亿。
据披露,Kimi K3.1 Pro 在延续前代核心架构的基础上,引入 DeepSeek 提出的稀疏注意力机制 DSA,将原有 24 层全注意力结构替换为 Gated DSA,以进一步优化长上下文处理效率。
权重与架构公开
此次公开的内容包括模型权重文件与完整架构信息,发布渠道为 Hugging Face,时间在今日凌晨。这意味着外部开发者可以直接获取这一超大规模模型的结构参数,而不仅限于通过 API 调用其能力。
与权重一同受到关注的是该模型在 Agent Arena 榜单上的位置。据披露,Kimi K3.1 Pro 在该榜单中位列开放模型第一名,这一排名与其 2.8 万亿的总参数量共同构成此次发布的主要看点。
从发布形态看,月之暗面延续了此前以开放权重参与竞争的路线。来源将此次动作与 DeepSeek 并列讨论,认为两家公司在模型打法上出现了新的变化,但未给出更多关于授权条款或后续版本计划的说明。
混合注意力结构
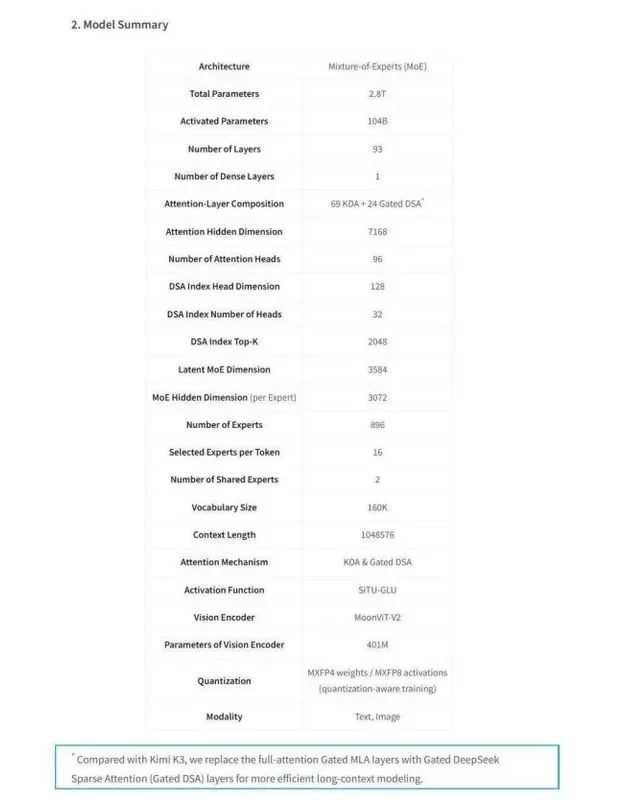
替换之后,模型整体采用混合注意力结构:69 层 Kimi Delta Attention(KDA)与 24 层 Gated DSA 组合,合计 93 层。注意力隐藏维度为 7168,配置 96 个注意力头。
两种注意力层承担不同职能。KDA 通过压缩历史信息的状态表示,降低处理长序列时的存储开销;Gated DSA 则借助稀疏检索,在部分注意力层中保留对重要历史 Token 进行精确计算的能力。按来源的表述,两者结合使模型既能高效处理长序列,也能在需要时从大量历史信息中定位关键内容。
MoE 参数配置
Kimi K3.1 Pro 沿用混合专家架构(MoE),总参数量为 2.8 万亿,但每个 Token 实际激活的参数量约为 1040 亿。这一总参数与激活参数的差距,是该模型控制单次推理计算量的主要设计。
专家配置上,模型设置 896 个路由专家,每个 Token 选择其中 16 个参与计算,另设 2 个共享专家。MoE 潜在维度为 3584,每个专家的隐藏维度为 3072。
来源同时提到,除引入 DeepSeek DSA 之外,该模型还延续了月之暗面在超大规模模型计算效率方面的优化设计,但未展开说明这些设计的具体内容。
长上下文效率数据
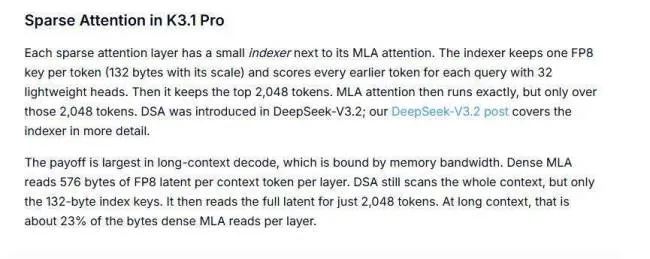
关于稀疏注意力的实际收益,来源引用了 vLLM 团队的技术分析。在长上下文解码场景下,Kimi K3.1 Pro 采用 DSA 后,相关注意力层的内存读取量可降至原有稠密 MLA 方案的约 23%。
这一数字对应的是注意力层的内存读取环节,而非整体推理开销。结合 KDA 对历史信息状态表示的压缩,来源将长上下文处理效率的优化列为该版本相对前代的主要改进方向。
目前公开的信息集中在架构与效率指标,尚未涉及训练数据规模、评测细项或部署成本等内容。模型权重已在 Hugging Face 开放,后续的外部复现与评测结果有待观察。
要点
- Kimi K3.1 Pro 权重与架构在 Hugging Face 公开
- 该模型在 Agent Arena 榜单位列开放模型第一
- 总参数量 2.8 万亿,每 Token 激活约 104B
- 采用 69 层 KDA 与 24 层 Gated DSA 混合结构
- vLLM 分析称相关注意力层内存读取量降至约 23%
正在读取登录状态…
暂无讨论,说说你的看法吧