 Mores
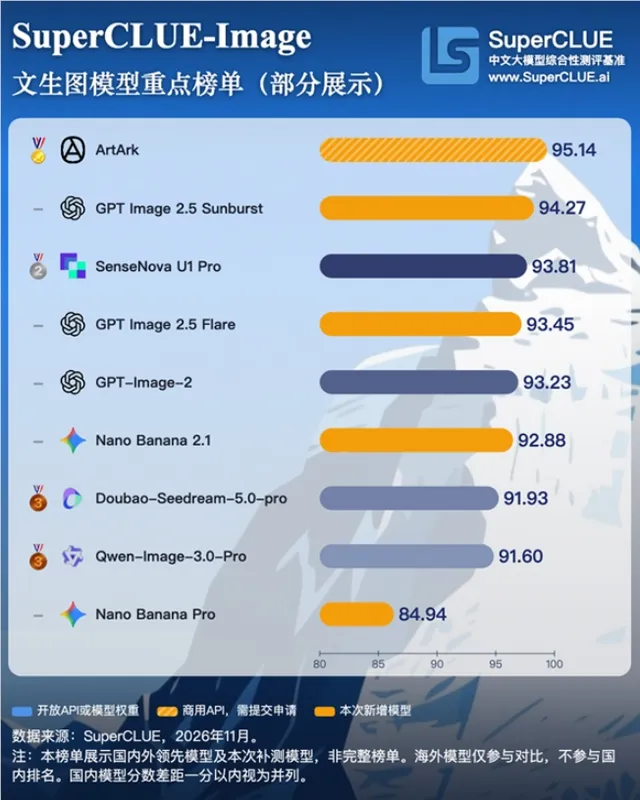
11月10日,SuperCLUE发布2026年11月文生图基准更新榜单,首次引入国内最新模型ArtArk以及GPT系列、Nano Banana系列等补充测评。国产模型ArtArk以95.14分的综合成绩位列总榜第一,超过GPT Image2.5Sunburst。
在图文一致性测试项目中,ArtArk拿下所有参测模型中的唯一一个满分。榜单前五名最高分与最低分之间仅相差1.91分,国内外头部产品竞争处于高度胶着状态。
榜单与参测阵容
此次更新榜单由SuperCLUE发布,覆盖海内外主流文生图产品。与以往不同的是,本期首次将国内最新模型ArtArk纳入测评,同时补充了GPT系列与Nano Banana系列等模型参与对比,使参测阵容在国内外两个方向上都有扩展。
从最终结果看,新加入的ArtArk直接进入总榜首位,而GPT系列与Nano Banana系列的多款版本也分布在榜单前列,构成本期榜单的主要竞争格局。
ArtArk登顶与满分项
在图文一致性项目中,ArtArk是全部参测模型中唯一拿到满分的产品。该指标考察模型对文字指令的理解程度,以及将主体人物、物品道具、空间场景与相互关系等描述准确转化为画面的能力,要求模型在保证画面美观的同时按指令还原细节。
据来源介绍,这一满分表明ArtArk在复杂语义理解与画面对齐方面达到了顶尖水准,其登顶并非依赖某一单项的微弱优势,而是综合理解与还原能力的体现。
头部梯队分差
总榜前五名的最高分与最低分之间仅相差1.91分,头部产品之间的技术差距被压缩到很小范围。海外模型中,GPT Image2.5Sunburst以94.27分位列总榜第二,同系列GPT Image2.5Flare以93.45分紧随其后。
国产梯队方面,SenseNova U1Pro以93.81分排名国内第二,Doubao-Seedream-5.0-pro与Qwen-Image-3.0-Pro并列国内第三。国内外头部产品由此形成高度胶着的竞争状态。
各模型差异化优势
总分接近的同时,各款模型在细分能力上呈现出不同侧重。GPT Image2.5Sunburst在汉字生成和现实复现两个项目中拿到全场最高分;GPT Image2.5Flare则在整体图像质量与图文一致性上表现优异,后者得分为93.94分。
创作与布局方面,GPT-Image-2在创意与推理项目上得分96.81分,复杂信息布局得分94.04分;国内模型SenseNova U1Pro在复杂信息布局上以95.80分位居所有参测模型首位。
Nano Banana系列也取得明显进步,其中Nano Banana2.1是该系列最高分版本,得分92.88分,其图文一致性与复杂信息布局能力相比前代分别提升9.09分和6.87分。
评测标准的变化
从本期各项目的得分分布看,文生图模型的评判重点已不再局限于画面是否美观。能否准确理解人类指令、处理复杂画面布局以及精准生成特定文字,正在成为衡量图像生成能力的核心指标。
汉字生成、现实复现、创意与推理、复杂信息布局等细分项目在本期榜单中各自产生了领先者,说明单一总分之外,能力结构的分化同样受到关注。ArtArk的登顶也被来源视为国产文生图模型具备与海外头部产品正面抗衡实力的一个信号。
要点
- ArtArk综合得分95.14分,位列总榜第一
- GPT Image2.5Sunburst以94.27分排名第二
- SenseNova U1Pro以93.81分居国内第二
- 前五名最高分与最低分仅相差1.91分
- ArtArk是图文一致性项目唯一满分模型
正在读取登录状态…
暂无讨论,说说你的看法吧